Agenten betreiben ist Betrieb: die alten Disziplinen gelten weiter
KI-Agenten betreiben ist kein neues Fach: Identität, minimale Rechte, Change-Management, SLOs, Kosten und Audit gelten weiter. Auftakt einer Betriebsreihe.
Dieser Beitrag ist auch auf English verfügbar.
„AI Agent Operations“ klingt nach einer neuen Disziplin mit eigenem Vokabular. Tatsächlich ist es überwiegend die alte. Ein Modell erledigt die Arbeit statt eines Menschen oder eines Skripts, aber die Fragen, die ein Plattform-Team beantworten muss, kennt der Betrieb seit Jahrzehnten: Wer handelt? Was darf er anfassen? Wie ändern wir das sicher? Woran erkennen wir, dass es gesund ist? Was kostet es? Und was passiert, wenn es um 3 Uhr nachts ausfällt? Dieser Beitrag eröffnet eine wiederkehrende Reihe. Jeder spätere Beitrag nimmt eine klassische Disziplin und überträgt sie auf eine Agenten-Plattform.
Warum diese Sicht hilft
Teams, die Agenten für Magie halten, erfinden den Betrieb schlecht neu. Sie liefern einen Prompt aus, geben ihm einen gemeinsamen API-Schlüssel und entdecken die fehlenden Teile Vorfall für Vorfall. Teams, die Agenten als neue Art Dienst mit einer probabilistischen Komponente im Inneren behandeln, können fast alles wiederverwenden, was sie schon wissen.
Das heißt nicht, dass nichts anders wäre. Drei Eigenschaften modellgetriebener Arbeiter verändern, wie die alten Disziplinen anzuwenden sind:
- Das Verhalten ist nicht vollständig vorhersehbar. Dieselbe Eingabe kann zu anderen Schritten führen. Kontrollen müssen deshalb außerhalb des Modells sitzen, wo sie deterministisch sind.
- Eingabe ist Anweisung. Text aus einem Ticket, einer Webseite oder einem Tool-Ergebnis kann das Modell lenken. Jeder Eingabekanal ist eine Vertrauensgrenze.
- Kosten folgen der Nutzung. Eine Schleife mit Wiederholungen kostet in jedem Zug Geld. Budgets sind eine Betriebskontrolle, kein Anhängsel der Buchhaltung. Das haben wir in Kosten sind Aufgabe der Plattform behandelt.
Zwölf Disziplinen im Überblick
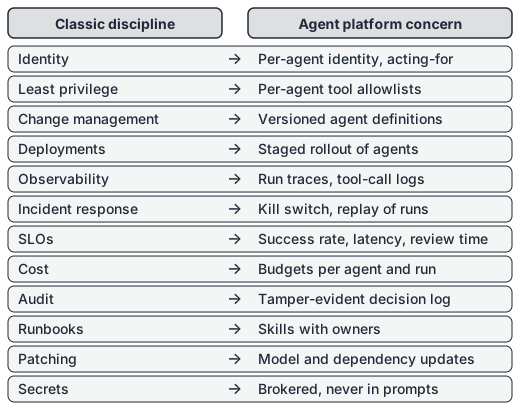
Das Diagramm oben ist der Index der Reihe. In Worten:
- Identität. Jeder Dienst hat eine eigene Identität. Ein Agent braucht eine, dazu den Vermerk, in wessen Auftrag er handelt, damit eine Logzeile „wer, für wen“ beantwortet.
- Minimale Rechte. Tool-Allowlists je Agent statt eines mächtigen Agenten. Der Ausgangspunkt ist, die Arbeit auf kleine Agenten mit engen Rechten zu verteilen.
- Change-Management. Agentendefinitionen, Prompts, Skills und Policies sind Code. Sie werden versioniert, geprüft und wie Code zurückgerollt.
- Deployments. Eine neue Agentenversion geht schrittweise raus, nicht auf einmal an alles, und lässt sich schnell abschalten.
- Observability. Spuren der Läufe, Tool-Aufrufe mit Argumenten, Token-Verbrauch und Entscheidungen, damit sich Verhalten ohne Raten rekonstruieren lässt.
- Incident Response. Ein Notaus, eine Möglichkeit, Rechte zu entziehen, eine wiederholbare Aufzeichnung und eine anschließende Nachbesprechung ohne Schuldzuweisung.
- SLOs. Ziele für Erfolgsquote, Latenz und bei Agenten auch dafür, wie lange die menschliche Prüfung dauert.
- Kosten. Budgets je Agent und je Lauf, mit hartem Stopp.
- Audit. Ein manipulationssicheres Protokoll der Entscheidungen. Siehe Policy entscheidet, Audit beweist.
- Runbooks. Dokumentierte Abläufe mit Verantwortlichen; bei Agenten oft als Skills verpackt.
- Patching. Modellversionen, Abhängigkeiten, Tool-Server und Images altern und brauchen einen Update-Pfad.
- Secrets. Zugangsdaten übergibt die Plattform an Tools. Sie stehen nie in Prompts.
Was die Klassiker sagen
Nichts davon ist neu, und die Primärquellen lohnen die Lektüre. Googles SRE-Buch definiert Toil (wiederkehrende Handarbeit) so; das Zitat bleibt im englischen Original:
Toil is the kind of work tied to running a production service that tends to be manual, repetitive, automatable, tactical, devoid of enduring value
— Google, Site Reliability Engineering, Chapter 5: Eliminating Toil
Eine Agenten-Plattform erzeugt neuen Toil, wenn niemand darauf achtet: Freigaben, die immer durchgeklickt werden, Alarme, die niemand liest, manuelle Neustarts. Dieselbe Definition gilt.
Zu Service-Level-Zielen ist das Buch ebenso direkt:
An SLO is a service level objective: a target value or range of values for a service level that is measured by an SLI.
— Google, Site Reliability Engineering, Chapter 4: Service Level Objectives
Bei Agenten ändert sich, was gemessen wird (Aufgabenerfolg, Fehlerquote der Tool-Aufrufe, Zeit bis zur Prüfung), nicht aber die Struktur: ein Ziel für etwas Messbares. Beide Kapitel sind Online- Ausgaben eines Buches von 2016; die Webseiten selbst tragen kein Datum.
Beim Vertrauen passt NISTs Zero-Trust-Architektur gut zu Agenten, denn der Netzwerkstandort eines Agenten sagt nichts darüber, ob ihm zu trauen ist:
Zero trust assumes there is no implicit trust granted to assets or user accounts based solely on their physical or network location
Und die Leitlinien des britischen National Cyber Security Centre für KI-Systeme nutzen bereits eine Lebenszyklus-Sicht, die den Betrieb einschließt:
four key areas within the AI system development life cycle: secure design, secure development, secure deployment, and secure operation and maintenance
— UK NCSC, Guidelines for secure AI system development
Der vierte Bereich, Betrieb und Wartung, ist das Thema dieser Reihe.
Eine Start-Checkliste
Wer heute Agenten betreibt und wissen will, wo er steht, beantwortet diese Fragen ohne nachzuschlagen:
- Lassen sich alle Agenten in Produktion mit Verantwortlichen und den gehaltenen Tools auflisten?
- Hat jeder Agent eine eigene Identität, oder teilen sich mehrere einen Schlüssel?
- Lässt sich ein Agent binnen einer Minute stoppen, ohne die anderen anzuhalten?
- Lassen sich die letzten zehn Tool-Aufrufe eines Laufs samt Argumenten zeigen?
- Gibt es ein Budget mit hartem Stopp je Lauf und je Tag?
- Liegen Prompts, Skills und Policies in der Versionskontrolle mit Review?
- Gibt es ein Runbook für die drei wahrscheinlichsten Störungen?
- Wer patcht Modellversion, Tool-Server und Images, und wie oft?
Wer weniger als die Hälfte beantworten kann, hat eine Betriebslücke, kein Qualitätsproblem des Modells. Bessere Prompts schließen sie nicht.
Was diese Reihe leisten wird und was nicht
Sie ordnet jeder Disziplin konkrete Kontrollen einer Agenten-Plattform zu, sagt, welcher Teil durch etablierte Praxis gelöst ist und welcher wirklich neu, und benennt Grenzen ehrlich. Sie behauptet nicht, dass irgendeine Plattform, auch open-agentix, diese Probleme verschwinden lässt. Betrieb ist Arbeit. Der Sinn einer Plattform ist, dass diese Arbeit sichtbar, wiederholbar und im Code statt in Gewohnheiten durchgesetzt ist.
Das Wichtigste in Kürze
- Agentenbetrieb ist Betrieb: Identität, minimale Rechte, Änderungen, Deployments, Observability, Vorfälle, SLOs, Kosten, Audit, Runbooks, Patching, Secrets.
- Neu ist, dass Verhalten probabilistisch und Eingabe Anweisung ist; Kontrollen müssen deshalb außerhalb des Modells sitzen.
- Bestehende Quellen wie das SRE-Buch, NIST SP 800-207 und die NCSC-Leitlinien gelten mit wenig Übertragung.
- Die Checkliste deckt Lücken auf; die meisten sind betrieblich, nicht modellbedingt.
- Dieser Beitrag ist der Index einer Reihe, die die zwölf Disziplinen nacheinander durchgeht.
Quellen
- Google, Site Reliability Engineering, Chapter 5: Eliminating Toil (Buch erschienen 2016)
- Google, Site Reliability Engineering, Chapter 4: Service Level Objectives (Buch erschienen 2016)
- NIST, SP 800-207, Zero Trust Architecture (2020-08-11)
- UK NCSC, Guidelines for secure AI system development (2023-11-27)
- Frühere Beiträge dieses Blogs: Warum open-agentix