Betriebsreihe: Audit-Trails sind keine Logs
Ein AI audit trail muss vollständig, zurechenbar und manipulationssicher erkennbar sein; Logs dienen der Fehlersuche. Wie man sie trennt und was wohin gehört.
Dieser Beitrag ist auch auf English verfügbar.
Ein AI audit trail und ein Anwendungslog beantworten verschiedene Fragen. Logs und Traces helfen Entwickelnden herauszufinden, warum etwas kaputtging, deshalb dürfen sie gesampelt, gefiltert und rotiert werden. Ein Audit-Trail muss belegen, was geschehen ist, und deshalb vollständig, einer Identität zurechenbar und manipulationssicher erkennbar sein. Agentenplattformen brauchen beides, gespeist aus demselben Lauf, aber unterschiedlich gespeichert, geschützt und aufbewahrt. Wer beides vermischt, bekommt ein Log, das zu dünn ist, um ihm zu trauen, oder einen Audit-Speicher, der zu laut ist, um ihn zu lesen.
Zwei Aufgaben, zwei Anforderungsprofile
Fragen Sie, wofür der jeweilige Datensatz da ist.
- Telemetrie (Logs, Traces, Metriken) dient der Fehlersuche und dem Betrieb. Sie ist nützlich, wenn sie billig, schnell abfragbar und verlusttolerant ist. 90 % der Debug-Zeilen in einem gesunden System zu verwerfen, ist ein Vorzug.
- Ein Audit-Trail dient dazu, später Fragen zu beantworten, oft von jemandem, der nicht dabei war: Wer hat diese Aktion genehmigt, was genau war es, was hat die Richtlinie entschieden, was hat sich geändert. Er ist nur nützlich, wenn nichts fehlt und niemand ihn unbemerkt ändern konnte.
| Eigenschaft | Telemetrie | Audit-Trail |
|---|---|---|
| Hauptleser | Entwickelnde bei der Fehlersuche | Prüfende, Sicherheit, Verantwortliche, manchmal Aufsicht oder Kunden |
| Vollständigkeit | Sampling ist in Ordnung | Jedes relevante Ereignis, keine Lücken |
| Zurechnung | Oft ein Dienstname | Eine bestimmte Identität: Nutzer, Agent, Delegationskette |
| Integrität | Nach bestem Bemühen | Manipulationssicher erkennbar (etwa per Hash-Kette) |
| Aufbewahrung | Tage oder Wochen, rotiert | Per Richtlinie festgelegt, oft Monate oder Jahre |
| Inhalt | Ausführlich, technisch | Strukturiert, knapp, stabiles Schema |
| Fehlerbild | Eine fehlende Zeile ist lästig | Ein fehlender Datensatz ist ein Befund |
Wie Telemetrie bei Agenten aussieht
Agententelemetrie hat eine natürliche Form: Ein Lauf ist ein Baum aus Schritten. Die Dokumentation des OpenAI Agents SDK beschreibt die oberste Einheit so:
Traces represent a single end-to-end operation of a “workflow”.
Quelle: OpenAI Agents SDK docs, Tracing. Sinngemäß: Ein Trace stellt eine einzelne Ende-zu-Ende-Operation eines „Workflows“ dar.
Innerhalb eines Traces finden sich Spans für Modellaufrufe, Tool-Aufrufe und Übergaben, mit Zeiten und oft den Nutzdaten. Genau das braucht man, um zu sehen, warum ein Lauf langsam war oder falsch abbog. Es macht Telemetrie aber auch zu einem schlechten Audit-Datensatz: Sie ist auf die falsche Weise detailliert (große Prompts, Rauschen), meist gesampelt und liegt oft in Systemen, die viele Entwickelnde ändern oder leeren können.
Im weiteren Ökosystem wird an gemeinsamen Formaten gearbeitet. Das OpenTelemetry-Projekt schreibt, sein Ziel sei:
establish standards around the shape of the telemetry generated by agent apps to avoid lock-in
Quelle: OpenTelemetry, AI Agent Observability - Evolving Standards and Best Practices (2025-03-06). Sinngemäß: Standards für die Form der von Agentenanwendungen erzeugten Telemetrie schaffen, um Abhängigkeit von einem Anbieter zu vermeiden.
Nutzen Sie solche Standards für Telemetrie, damit Sie das Backend wechseln können. Zur praktischen Seite des Tracings von Agenten siehe Observability für Agenten. Für Audit braucht es einen anderen Entwurf.
Was ein Audit-Trail enthalten muss
Ein Audit-Ereignis sollte klein, strukturiert und unspektakulär sein. Für eine Agentenplattform ist dies ein brauchbares Minimum:
- Wann: ein Zeitstempel einer vertrauenswürdigen Uhr.
- Wer: die handelnde Identität, einschließlich in wessen Auftrag und über welche Delegationskette. Siehe Agenten-Identität und Delegation.
- Was: die Aktion, etwa ein Tool-Aufruf mit (geschwärzten) Argumenten, eine Freigabe, eine Richtlinienänderung, ein Deployment.
- Entscheidung: was das Richtlinien-Gate entschieden hat (erlauben, ablehnen, Freigabe verlangen) und welche Regel galt.
- Ergebnis: Erfolg oder Fehlschlag und ein Verweis auf das Resultat.
- Korrelation: Lauf- und Trace-ID, damit man für Details zur Telemetrie springen kann.
- Integritätsdaten: ein Hash, der diesen Datensatz mit dem vorherigen verknüpft.
Ein Beispielereignis:
{
  "seq": 18422,
  "time": "2026-07-28T09:14:03Z",
  "actor": { "agent": "refund-triage", "run": "run_7f3a", "on_behalf_of": "user:support-lead" },
  "action": { "tool": "tickets.comment", "args": { "ticket": "SUP-1841", "comment_sha256": "9c1e..." } },
  "decision": { "result": "allow", "rule": "comment-after-review" },
  "outcome": "ok",
  "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
  "prev_hash": "a41c...",
  "hash": "e07b..."
}
Beachten Sie den Hash des Kommentartexts statt des Texts: Ein Audit-Datensatz soll belegen, was getan wurde, ohne zur zweiten Kopie sensibler Daten zu werden.
Welche Ereignisse wohin gehören
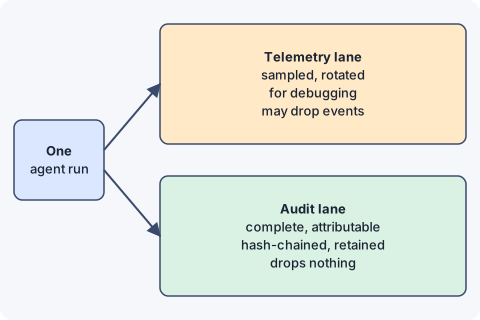
Ein Lauf erzeugt beide Ströme. Eine einfache Regel zur Verteilung:
| Ereignis | Telemetrie | Audit |
|---|---|---|
| Latenz und Token-Zahlen von Modellaufrufen | ja | nein (aggregierte Kosten können auditiert werden) |
| Voller Prompt- und Antworttext | gesampelt, mit Schwärzung | nein, nur Hash oder Verweis |
| Tool-Aufruf, der Daten liest | ja | ja, wenn die Daten sensibel sind |
| Tool-Aufruf, der Zustand ändert | ja | ja, immer |
| Richtlinienentscheidung (erlauben, ablehnen, freigeben) | ja | ja, immer |
| Menschliche Freigabe oder Ablehnung | ja | ja, immer |
| Änderung an Agent, Skill oder Richtlinie | ja | ja, immer |
| Wiederholung, Cache-Treffer, Debug-Meldung | ja | nein |
Der Test: Wenn in einem Jahr jemand fragt „Wer hat das erlaubt und was genau ist passiert?“, könnten Sie die Frage allein aus diesem Strom beantworten? Wenn ja, gehört das Ereignis ins Audit.
Einen Audit-Trail manipulationssicher erkennbar machen
Manipulationssicher erkennbar heißt nicht manipulationssicher. Es heißt, dass Änderung oder Löschung eines Datensatzes bemerkbar wird. Die üblichen Bausteine:
- Nur anhängende Schreibzugriffe. Die Plattformkomponente, die Ereignisse aufzeichnet, kann hinzufügen, aber nicht ändern oder löschen.
- Hash-Verkettung. Jeder Datensatz enthält den Hash des vorherigen, sodass Entfernen oder Ändern eines Datensatzes alle späteren Hashes bricht.
- Regelmäßiges Verankern. Den neuesten Hash an einem Ort speichern, den die Administratoren der Plattform nicht umschreiben können, etwa in einem getrennten System oder auf einmal beschreibbarem Speicher.
- Getrennter Zugriff. Wer Agenten betreibt, ist nicht dieselbe Person, die den Audit-Speicher verwalten kann.
- Verifikation. Ein Job berechnet die Kette planmäßig neu und alarmiert bei einem Bruch.
Ohne Verankerung kann eine Angreiferin mit voller Kontrolle über den Speicher die ganze Kette neu aufbauen. Hash-Verkettung hebt die Hürde, sie ersetzt keine Zugriffskontrolle.
Aufbewahrung und Datenschutz
Vollständigkeit hat Kosten, und nicht nur beim Speicher. Audit-Datensätze können personenbezogene Daten enthalten. Halten Sie sie knapp: Kennungen und Verweise statt Inhalt, geschwärzte Argumente, Hashes, wo Inhalt belegt, aber nicht aufbewahrt werden soll. Legen Sie die Aufbewahrung per Richtlinie und nach den für Sie geltenden Regeln fest und löschen Sie planmäßig. Eine lange Aufbewahrung ist nicht automatisch besser.
Für Rahmenwerke, die Nachweise für Aufsicht verlangen, ist der Audit-Trail das Rohmaterial. Das NIST AI RMF etwa sagt über sich selbst:
The NIST AI Risk Management Framework (AI RMF) is intended for voluntary use and to improve the ability to incorporate trustworthiness considerations
Quelle: NIST, AI Risk Management Framework. Sinngemäß: Das Rahmenwerk ist für die freiwillige Nutzung gedacht, um Aspekte der Vertrauenswürdigkeit besser einzubeziehen.
Es schreibt kein Log-Format vor, die oben genannten Entwurfsentscheidungen liegen also bei Ihnen. Es verlangt im Kern, dass Sie zeigen können, wie Ihr System gesteuert und gemessen wird, und ein vollständiger, zurechenbarer Datensatz ist der Weg dahin. Wie Richtlinie und Audit zusammenspielen, steht in Die Richtlinie entscheidet, das Audit belegt.
Häufige Fehler
- Das Anwendungslog als Audit-Trail verwenden. Es ist gesampelt, rotiert, änderbar und unstrukturiert.
- Alles auditieren. Ein Trail mit jedem Debug-Ereignis versteckt die wichtigen und treibt die Kosten.
- Anonyme Akteure. „agent-service“ ist keine Identität. Halten Sie Lauf, Agent und den Menschen oder das System fest, für das er handelte.
- Geheimnisse oder volle Prompts speichern. Audit-Speicher werden von mehr Leuten gelesen, als man denkt.
- Nie verifizieren. Eine Kette, die niemand prüft, ist Dekoration.
Das Wichtigste in Kürze
- Telemetrie hilft bei der Fehlersuche und darf gesampelt und rotiert werden; ein Audit-Trail muss vollständig, zurechenbar und manipulationssicher erkennbar sein.
- Beide aus demselben Lauf speisen, aber getrennt speichern, schützen und aufbewahren.
- Jede Zustandsänderung, jede Richtlinienentscheidung, jede Freigabe und jede Änderung an Agenten, Skills und Richtlinien auditieren.
- Datensätze per Hash verketten, den neuesten Hash andernorts verankern und die Kette regelmäßig prüfen.
- Audit-Datensätze knapp halten, um Datenschutz und Kosten zu schützen.
Quellen
- AI Agent Observability - Evolving Standards and Best Practices, OpenTelemetry, 2025-03-06.
- Tracing, Dokumentation des OpenAI Agents SDK.
- AI Risk Management Framework, NIST, 2023-01-26.