Die OWASP Top 10 für agentische Anwendungen aus Sicht eines Plattform-Teams
Wie ein Plattform-Team die OWASP agentic top 10 und verwandte LLM-Top-10-Einträge in Kontrollen übersetzt: minimale Rechte, Sandboxing, Freigaben und Audit.
Dieser Beitrag ist auch auf English verfügbar.
Die OWASP agentic top 10 benennt die größten Sicherheitsrisiken von Agentensystemen; Aufgabe eines Plattform-Teams ist es, jedes Risiko in eine Kontrolle zu übersetzen, die auch dann hält, wenn das Modell sich irrt oder manipuliert wird. Dieser Beitrag zeigt einen praktischen Weg, die Liste zu lesen: Risiken danach gruppieren, was sie einem Angreifer oder einem Fehler erlauben, und jede Gruppe auf eine Kontrolle abbilden, die eine Plattform durchsetzen kann, mit Verweisen auf frühere Beiträge, die die Kontrollen im Detail behandeln.
Was die Liste ist
Das OWASP Gen AI Security Project hat eine Liste veröffentlicht, die sich an Agenten statt an reine Chatmodelle richtet. Den Zweck beschreibt es so:
identifies the most critical security risks facing autonomous and agentic AI systems.
Quelle: OWASP Top 10 for Agentic Applications for 2026 (veröffentlicht 2025-12-09). Sinngemäß: Sie benennt die kritischsten Sicherheitsrisiken autonomer und agentischer KI-Systeme.
Der Unterschied zur früheren LLM-Liste ist wichtig. Ein Chatbot kann etwas Falsches sagen. Ein Agent kann etwas Falsches tun: Tools aufrufen, Datensätze ändern, Geld ausgeben, an andere Agenten delegieren. Die Risiken konzentrieren sich deshalb darauf, was das System darf und was es steuern kann.
Ein Hinweis zur Methode. Dieser Beitrag gibt die einzelnen Einträge und ihre Nummerierung nicht wieder; für genaue Namen und Wortlaut gilt die OWASP-Seite. Stattdessen gruppiert er Risiken in Themen, die in Agentenvorfällen immer wiederkehren, damit ein Plattform-Team Kontrollen planen kann, ohne eine Liste auswendig zu lernen. Gleichen Sie die Zuordnung mit dem aktuellen Text der Liste ab, bevor Sie sie in einem Audit verwenden.
Eine Zuordnung zu Kontrollen
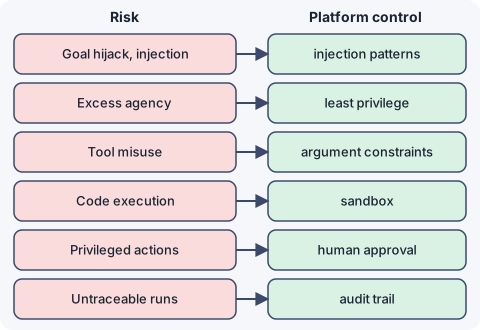
| Thema | Was schiefgehen kann | Plattformkontrolle |
|---|---|---|
| Manipulierte Ziele und Anweisungen | Feindseliger Text in einem Dokument, Ticket oder einer Webseite steuert den Agenten | Entwurfsmuster gegen Injection, Trennung von vertrauenswürdiger und nicht vertrauenswürdiger Eingabe |
| Übermäßige Handlungsmacht | Der Agent hat mehr Tools, Rechte oder Autonomie, als seine Aufgabe braucht | Minimale Rechte je Agent, Tool-Allowlists |
| Missbrauch von Tools | Gültige Tools werden mit schädlichen Argumenten aufgerufen | Argumentbeschränkungen, Aufruflimits, Richtlinienprüfung vor der Ausführung |
| Unsichere Code- und Befehlsausführung | Erzeugter Code oder Shell-Befehle laufen mit echtem Zugriff | Sandboxing, keine ambienten Zugangsdaten |
| Privilegierte Aktionen ohne Aufsicht | Nicht umkehrbare Aktionen geschehen, ohne dass jemand hinsieht | Menschliche Freigabe für riskante Schritte |
| Undurchsichtiges Verhalten | Niemand kann sagen, was lief, als wer und warum | Identität je Lauf, vollständiger Audit-Trail |
Jede Zeile ist durch eine Kontrolle abgedeckt, die nicht davon abhängt, dass sich das Modell richtig verhält. Darum geht es.
Übermäßige Handlungsmacht und minimale Rechte
Der Eintrag der LLM-Top-10 zu übermäßiger Handlungsmacht (Excessive Agency) stellt eine klare Diagnose:
The root cause of Excessive Agency is typically one or more of: excessive functionality; excessive permissions; excessive autonomy.
Quelle: OWASP, LLM06:2025 Excessive Agency. Sinngemäß: Die Ursache liegt meist in übermäßiger Funktionalität, übermäßigen Berechtigungen oder übermäßiger Autonomie, einzeln oder kombiniert.
Für jede der drei gibt es eine Antwort der Plattform:
- Übermäßige Funktionalität lösen Sie, indem der Agent nur die Tools sieht, die sein Schritt braucht.
- Übermäßige Berechtigungen lösen Sie durch Zugangsdaten, die auf ein Tool und einen Zweck begrenzt sind, nie durch ein gemeinsames Admin-Token.
- Übermäßige Autonomie lösen Sie durch Freigabeschranken und Grenzen dafür, wie lange und wie weit ein Lauf gehen darf.
Minimale Rechte für Agenten beschreibt, wie man einen mächtigen Agenten in mehrere kleine zerlegt, die jeweils nur die Fähigkeiten ihres Schritts haben. Das ist die wichtigste strukturelle Verteidigung gegen diese ganze Gruppe.
Manipulierte Anweisungen und Prompt-Injection
Der Eintrag zur Prompt-Injection enthält zwei Empfehlungen, die sich direkt auf Plattformfunktionen abbilden lassen:
Restrict the model’s access privileges to the minimum necessary for its intended operations.
Sinngemäß: Die Zugriffsrechte des Modells auf das für seine vorgesehenen Aufgaben notwendige Minimum beschränken.
Implement human-in-the-loop controls for privileged operations to prevent unauthorized actions.
Sinngemäß: Für privilegierte Operationen Kontrollen mit Menschen in der Schleife einführen, um unbefugte Aktionen zu verhindern.
Quelle: OWASP, LLM01:2025 Prompt Injection.
Eine Plattform kann nicht jede feindselige Anweisung im Text zuverlässig erkennen, also entwirft sie für den Fall, dass eine durchkommt. Entwurfsmuster gegen Prompt-Injection listet strukturelle Optionen auf, etwa Lesen und Handeln zu trennen und zwischen Schritten nur strukturierte Daten weiterzugeben. Das tödliche Trio liefert einen Schnelltest für den schlimmsten Fall: ein Agent, der Zugriff auf private Daten, Kontakt mit nicht vertrauenswürdigen Inhalten und einen Weg nach außen verbindet. Entfernt man eines der drei, verlieren die schädlichsten Angriffe ihren Weg.
Codeausführung und Sandboxing
Agenten, die Code oder Shell-Befehle ausführen, weiten die Angriffsfläche auf alles aus, was der Prozess erreicht. Die Kontrolle heißt Isolation: Solche Schritte laufen in einer Sandbox ohne Netz als Standard, mit schreibgeschütztem Dateisystem bis auf einen Arbeitsbereich, ohne geerbte Zugangsdaten und mit Ressourcengrenzen. Agenten in der Sandbox behandelt die Optionen und ihre Abwägungen. Betrachten Sie eine Sandbox als eine Schicht, nicht als die einzige; sie begrenzt den Schaden, sie macht schlechten Code nicht gut.
Menschliche Freigabe, wo es zählt
Freigabe ist die Kontrolle, zu der man zuerst greift und die man am schlechtesten einsetzt. Wer bei jedem Schritt um Bestätigung bittet, trainiert Prüfende zum Durchklicken. Setzen Sie sie gezielt ein:
- erforderlich bei nicht umkehrbaren oder nach außen sichtbaren Aktionen (Zahlungen, Löschungen, ausgehende Nachrichten, Änderungen in der Produktion),
- mit den genauen Argumenten angezeigt, nicht mit einer Zusammenfassung,
- entschieden von jemandem mit der Befugnis dazu und protokolliert,
- nicht vorhanden bei rein lesenden Schritten.
Verhalten sichtbar machen
Mehrere Themen setzen voraus, dass sich rekonstruieren lässt, was geschehen ist. Dafür braucht es eine Identität für jeden Lauf, eine Aufzeichnung jedes Tool-Aufrufs und jeder Richtlinienentscheidung und einen Weg, nachzuweisen, dass die Aufzeichnung nachträglich nicht verändert wurde. Die Audit-Seite behandeln Beiträge zu Richtlinie und Audit in diesem Blog; das Prinzip: Die Richtlinie entscheidet vor einer Aktion, der Audit-Trail belegt es danach.
So nutzen Sie die Liste in der Praxis
- Agenten inventarisieren. Je Agent: Tools, Zugangsdaten, lesbare Daten, mögliche Aktionen, wer freigibt.
- Die Themen durchgehen. Für jeden Agenten und jedes Thema die Kontrolle festhalten, wer sie verantwortet und woran man ihr Versagen erkennen würde.
- Lücken ehrlich markieren. „Noch keine Kontrolle“ ist ein nützlicher Eintrag; ein vages „durch das Training des Modells abgedeckt“ nicht.
- Kontrollen in Tests verwandeln. Pro Thema einige Angriffstestfälle schreiben, etwa ein Ticket mit feindseligem Text oder einen Tool-Aufruf mit Argument außerhalb des Bereichs, und bei jeder Änderung ausführen.
- Planmäßig überprüfen. Die Liste wird sich ändern, Ihre Agenten ebenso.
Was eine Top-10-Liste nicht leistet
Eine Risikoliste ist ein Ausgangspunkt. Sie gewichtet Risiken nicht für Ihre Umgebung, beschreibt Kontrollen nicht im Detail und ersetzt keine Tests. Zwei Agenten mit demselben Risiko können je nach Daten und Aktionen sehr unterschiedliche Kontrollen brauchen.
Das Wichtigste in Kürze
- Die agentic top 10 handelt davon, was Agenten tun können und was sie steuern kann, nicht nur davon, was sie sagen.
- Risiken zu Themen gruppieren und jedem eine Kontrolle zuordnen, die nicht auf dem Wohlverhalten des Modells beruht.
- Minimale Rechte, Argumentbeschränkungen, Sandboxing und Freigaben decken den größten Teil der Liste strukturell ab.
- Rekonstruierbares Verhalten (Identität, Audit-Trail) ist Voraussetzung, um auf irgendetwas zu reagieren.
- Die Zuordnung in Angriffstests überführen und regelmäßig überprüfen.
Quellen
- OWASP Top 10 for Agentic Applications for 2026, OWASP Gen AI Security Project, 2025-12-09.
- LLM06:2025 Excessive Agency, OWASP Gen AI Security Project.
- LLM01:2025 Prompt Injection, OWASP Gen AI Security Project.