Selbst betriebene Modelle für Agenten: was sich ändert, wenn die Inferenz bei dir läuft
Self-hosted LLM für Agenten: Prompts bleiben im Haus, Sie tragen aber Kapazität, Updates und Bewertung. Lokale Runtimes, Batch-Server und der Betriebsaufwand.
Dieser Beitrag ist auch auf English verfügbar.
Wer ein selbst betriebenes LLM nutzt, hält Prompts und Daten in der eigenen Infrastruktur und wird dafür selbst zum Modellanbieter: Sie dimensionieren die Hardware, wählen und aktualisieren die Gewichte, beobachten die Latenz und beurteilen die Qualität. Für einzelne Entwickelnde genügt eine lokale Runtime. Für viele gleichzeitig laufende Agenten braucht es eine Serving-Schicht, die Anfragen bündelt. In beiden Fällen verschwindet der Betriebsaufwand nicht, er wandert zu Ihrem Team.
Warum Teams selbst hosten
Die Gründe sind meist konkret, nicht ideologisch:
- Daten bleiben im Haus. Prompts, Tool-Ausgaben und Dokumente verlassen Ihr Netz nicht.
- Planbare Kosten. Nach der Anschaffung der Hardware kostet ein Token Strom und Betriebszeit statt einer Rechnungszeile.
- Netzunabhängigkeit. Die Plattform läuft weiter, wenn ein externer Anbieter ausfällt oder gar keine Verbindung ins Internet besteht (zum Beispiel in einem vollständig abgeschotteten Netz).
- Kontrolle über Versionen. Ein Modell ändert sich nicht unter Ihren Füßen, solange Sie es nicht selbst ändern.
Zum Datenschutz sagt die Ollama-Dokumentation direkt, was lokaler Betrieb bedeutet:
We don’t see your prompts or data when you run locally.
Quelle: Ollama docs, FAQ. Sinngemäß: Wir sehen Ihre Prompts oder Daten nicht, wenn Sie lokal arbeiten.
Beachten Sie, was der Satz aussagt: Der Hersteller der Runtime sieht Ihre Daten nicht. Er sagt nicht, dass sonst niemand sie sieht. Eigene Logs, das eigene Gateway und eigene Backups enthalten die Prompts weiterhin und brauchen denselben Schutz wie jeder andere sensible Speicher.
Zwei Betriebsformen
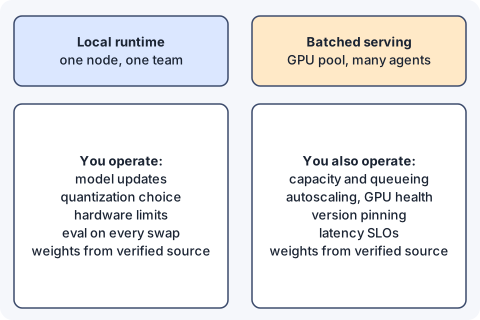
Eine lokale Runtime führt ein Modell auf einer Maschine aus, meist mit einer einfachen API darüber. Werkzeuge wie Ollama gehören hierher. Sie ist schnell eingerichtet, läuft auf einem Arbeitsplatzrechner oder einem einzelnen Server und passt zu Experimenten, kleinen Teams und Agenten, die nur gelegentlich laufen. Ihre Grenze ist die Parallelität: eine Maschine, eine begrenzte Zahl gleichzeitiger Anfragen.
Ein Serving-System mit Batching ist für viele parallele Anfragen gebaut. Der Kern des Problems: Text für viele Anfragen gleichzeitig zu erzeugen, nutzt die GPU weit besser als eine Anfrage nach der anderen, aber nur bei gutem Speichermanagement. Das Paper hinter vLLM nennt den Ausgangspunkt:
High throughput serving of large language models (LLMs) requires batching sufficiently many requests at a time.
Quelle: Efficient Memory Management for Large Language Model Serving with PagedAttention (arXiv, 2023-09-12). Sinngemäß: Hoher Durchsatz beim Betrieb großer Sprachmodelle erfordert, ausreichend viele Anfragen gleichzeitig zu bündeln.
Server dieser Klasse, darunter vLLM, sorgen dafür, dass die GPU über viele Agenten hinweg ausgelastet bleibt. Sie brauchen in der Regel mehr GPU-Speicher, mehr Feinabstimmung und mehr Überwachung als eine lokale Runtime, und sie werden für die Spitzenlast dimensioniert, nicht für die durchschnittliche Nutzung.
Eine grobe Entscheidungshilfe:
| Frage | Eher lokale Runtime | Eher Serving mit Batching |
|---|---|---|
| Gleichzeitige Agentenläufe | eine Handvoll | Dutzende und mehr |
| Wer betreibt es | die Entwickelnden selbst | ein Plattform- oder Betriebsteam |
| Latenzziel | „gut genug“ | ein vereinbartes Service-Level |
| Hardware | ein Rechner oder Server | ein oder mehrere GPU-Knoten |
Viele Teams beginnen mit der ersten Form und wechseln zur zweiten, wenn Warteschlangen sichtbar werden.
Der Betriebsaufwand, den Sie übernehmen
Eigene Inferenz bringt eine Liste von Pflichten mit, die eine gehostete API unbemerkt erledigt. Planen Sie jede ein.
Kapazität und Warteschlangen
Agenten arbeiten stoßweise: Eine Pipeline kann Dutzende Läufe auf einmal starten, jeder mit mehreren Modellaufrufen. Legen Sie fest, was bei voller Warteschlange geschieht. Möglich sind Warten, Ausweichen auf ein anderes Modell oder schnelles Scheitern mit klarer Fehlermeldung. Messen Sie die Zeit bis zum ersten Token und die Gesamtzeit je Anfrage, nicht nur den Durchsatz.
Modellauswahl und Updates
Wählen Sie Modelle passend zur Aufgabe: ein kleineres für Routing und Extraktion, ein größeres für Planung. Erscheint ein besseres Modell, behandeln Sie den Wechsel als Release. Lassen Sie Ihren Bewertungssatz darüber laufen, bevor es Verkehr bekommt, und halten Sie die Vorversion für einen Rückfall bereit. Ein Modellupdate ändert das Verhalten, auch wenn die Prompts gleich bleiben.
Bewertung, immer
Ein gehosteter Anbieter bewertet seine eigenen Modelle; das Modell, das Sie betreiben, müssen Sie selbst für Ihre Aufgaben bewerten. Halten Sie eine kleine Menge repräsentativer Läufe mit erwarteten Ergebnissen bereit und wiederholen Sie sie bei jedem Wechsel von Modell, Quantisierung oder Runtime. Quantisierung spart Speicher und kann Qualität kosten, was nur Ihre eigenen Tests zeigen.
Lieferkette für Gewichte und Runtimes
Modelldateien sind binäre Artefakte aus dem Internet, und die Serving-Software ist eine Abhängigkeit wie jede andere. OWASP führt das unter Lieferkettenrisiken und gibt eine klare Regel:
Only use models from verifiable sources and use third-party model integrity checks with signing and file hashes
Quelle: OWASP, LLM03:2025 Supply Chain. Sinngemäß: Nur Modelle aus überprüfbaren Quellen verwenden und Integritätsprüfungen Dritter mit Signaturen und Datei-Hashes einsetzen.
In der Praxis: beim Herausgeber herunterladen, den Hash festhalten, die Datei in einer internen Registry ablegen und die Serving-Knoten nur von dort ziehen lassen. Die Runtime und ihre Bibliotheken planmäßig patchen; der Ablauf entspricht dem aus Die Lieferkette von Agenten patchen.
Beobachtbarkeit und Service-Level
Hängen Agenten von Ihrem Inferenzdienst ab, braucht er Ziele wie jeder andere Dienst: Verfügbarkeit, Latenzperzentile und Fehlerrate. SLOs für Agenten zeigt, wie man sie auf Agentenebene definiert und Fehler bis zur Modellschicht zurückverfolgt. In der Serving-Schicht beobachten Sie GPU-Speicher, Warteschlangentiefe und die Zeit bis zum ersten Token.
Sicherheit des Endpunkts selbst
Ein Inferenz-Endpunkt ist eine interne API, die für jeden Aufrufer teure Arbeit erledigt. Setzen Sie Authentifizierung davor, begrenzen Sie, wer ihn erreicht, und protokollieren Sie Anfragen. Eine lokale Runtime, die ohne Authentifizierung an eine Netzwerkschnittstelle gebunden ist, schenkt jedem Rechner im Netz eine kostenlose GPU.
Selbst betriebene und gehostete Modelle kombinieren
Selbst hosten muss kein Entweder-oder sein. Ein verbreitetes Muster: Ein selbst betriebenes Modell bedient sensible Daten und Routineaufgaben, schwierige Fälle gehen über ein Gateway an einen gehosteten Anbieter, wie in BYOK für Agentenplattformen beschrieben. Das Gateway entscheidet je Agent, und eine Richtlinie legt fest, welche Datenklassen das Netz verlassen dürfen.
Was Selbsthosting nicht bringt
- Bessere Qualität von selbst. Open-Weight-Modelle unterscheiden sich; die besten gehosteten Modelle können weiterhin besser sein als das, was Sie betreiben können.
- Niedrigere Kosten bei geringer Last. Ungenutzte GPUs sind teuer. Rechnen Sie Hardware, Strom, Personalzeit und die Kosten von Fehlern ein.
- Weniger Arbeit. Die Arbeit verschiebt sich von der Anbieterverwaltung zum Betrieb.
Das Wichtigste in Kürze
- Selbsthosting hält Daten im Haus und macht Sie für Kapazität, Updates und Bewertung verantwortlich.
- Lokale Runtime für ein Team und gelegentliche Läufe, Serving mit Batching für viele parallele Agenten.
- Modellwechsel als Release behandeln, mit Bewertungslauf und Rückfallweg.
- Gewichte mit Hashes und Signaturen prüfen, Runtimes planmäßig patchen.
- Den Inferenz-Endpunkt mit Authentifizierung und Service-Level-Zielen versehen.
Quellen
- FAQ, Ollama-Dokumentation.
- Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv, 2023.
- LLM03:2025 Supply Chain, OWASP Gen AI Security Project.