Wann sind Multi-Agenten-Systeme ihre Tokens wert?
Multi-Agenten-Systeme parallelisieren Arbeit, vervielfachen aber den Tokenverbrauch. Einzelagent, Orchestrator-Worker und Pipeline im Vergleich.
Dieser Beitrag ist auch auf English verfügbar.
Multi-Agenten-Systeme lohnen sich, wenn die Aufgabe breit und parallelisierbar ist, wertvoll genug, um den Kontext mehrerer Agenten zu bezahlen, und wenn sich das Ergebnis prüfen lässt. Für die meisten anderen Aufgaben ist ein einzelner Agent mit guten Werkzeugen billiger, leichter zu debuggen und leichter zu steuern. Dieser Beitrag vergleicht drei Entwürfe, den Einzelagenten, das Orchestrator-Worker-Muster und die Pipeline, nach Kosten, Zuverlässigkeit und Governance, damit die Wahl bewusst fällt und nicht nach Mode.
Was die Belege zu den Kosten sagen
Anthropic hat sein Multi-Agenten-Forschungssystem offen beschrieben, einschließlich der Kosten. Zwei Aussagen sollte man nebeneinanderlegen. Die erste erklärt, warum der Ansatz überhaupt funktionieren kann (englisches Originalzitat; sinngemäß: Multi-Agenten-Systeme funktionieren hauptsächlich, weil sie helfen, genug Tokens für die Lösung des Problems einzusetzen):
Multi-agent systems work mainly because they help spend enough tokens to solve the problem.
Die zweite nennt den Preis (englisches Originalzitat; sinngemäß: Agenten verbrauchen etwa das Vierfache eines Chats, Multi-Agenten-Systeme etwa das Fünfzehnfache):
In our data, agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats.
Quelle: Anthropic, How we built our multi-agent research system. Die Zahlen stammen aus einem System für offene Recherche, Ihre Verhältnisse werden abweichen. Der strukturelle Punkt bleibt: Ein Multi-Agenten-Entwurf kauft Kapazität mit Tokens und zahlt sich nur aus, wenn der Wert der Aufgabe diesen Aufwand übersteigt. Deshalb sind Kosten eine Aufgabe der Plattform und nichts, was man auf der Rechnung entdecken sollte.
Die Forschung ist genauso nüchtern. Eine Studie zu Fehlern in Multi-Agenten-LLM-Systemen beginnt ihre Zusammenfassung mit einer Warnung (englisches Originalzitat; sinngemäß: Trotz der Begeisterung sind die Leistungsgewinne auf gängigen Benchmarks oft minimal):
Despite enthusiasm for Multi-Agent LLM Systems (MAS), their performance gains on popular benchmarks are often minimal.
Quelle: Why Do Multi-Agent LLM Systems Fail? (arXiv). Zusammen sagen beide Quellen dasselbe: Mehr Agenten sind nicht automatisch besser, und wo sie helfen, helfen sie durch parallelen Kontext und Breite, nicht durch Magie.
Drei Entwürfe
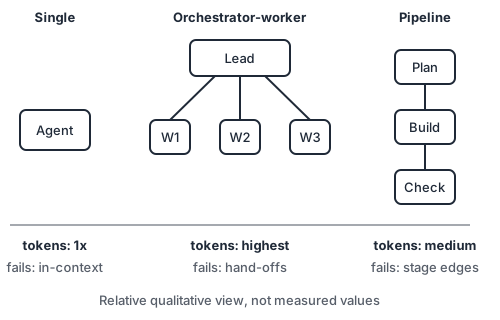
Einzelagent
Ein Agent, ein Kontext, eine Reihe von Werkzeugen. Er liest, entscheidet und handelt in einer Schleife.
- Kosten: am niedrigsten. Sie zahlen für einen Kontext, der im Lauf wächst.
- Zuverlässigkeit: Fehler bleiben in einem Trace, das macht sie leicht les- und reproduzierbar.
- Governance: eine Identität, eine Werkzeugliste, ein Audit-Trail.
- Grenzen: Das Kontextfenster ist die Decke. Breite Aufgaben (zwanzig Quellen sichten, hundert Dateien prüfen) werden flach oder sprengen den Platz.
Orchestrator-Worker
Ein führender Agent plant, startet Worker für Teilaufgaben parallel und führt die Ergebnisse zusammen.
- Kosten: am höchsten. Jeder Worker trägt seinen eigenen Kontext, und der Lead zahlt erneut für Lesen und Zusammenführen.
- Zuverlässigkeit: Fehler wandern an die Nahtstellen. Der Lead kann die Aufgabe schlecht aufteilen, Worker können doppelte Arbeit leisten oder widersprüchliche Aussagen liefern, und das Zusammenführen kann den Widerspruch verdecken.
- Governance: mehrere Identitäten und Werkzeugsätze. Jeder Worker braucht seinen eigenen Umfang; der Lead sollte nicht die Vereinigung aller erben.
- Stärken: Breite. Unabhängige Teilfragen laufen gleichzeitig, und der Kontext jedes Workers bleibt fokussiert. Die Claude-Code-Dokumentation beschreibt die Isolation, die das nützlich macht (englisches Originalzitat; sinngemäß: Jeder Subagent läuft in einem eigenen Kontextfenster mit eigenem System-Prompt, eigenem Werkzeugzugriff und eigenen Berechtigungen):
Each subagent runs in its own context window with a custom system prompt, specific tool access, and independent permissions.
Quelle: Claude-Code-Dokumentation, Create custom subagents (Live-Dokumentation, Wortlaut Stand 2026-10-04). Unabhängige Berechtigungen sind der Governance-Hebel: Worker können weniger bekommen als der Lead.
Pipeline
Feste Stufen, jede von einem spezialisierten Agenten oder einer gewöhnlichen Funktion erledigt: planen, bauen, prüfen. Der Kontrollfluss steht in Ihrem Code oder Workflow, nicht in der Entscheidung eines Modells.
- Kosten: moderat und vorhersehbar, weil die Zahl der Stufen feststeht.
- Zuverlässigkeit: Fehler konzentrieren sich an den Stufengrenzen. Definieren Sie jede Übergabe als typisierten Datensatz und validieren Sie ihn; siehe Übergaben und Verträge.
- Governance: die einfachste der Multi-Agenten-Optionen, weil jede Stufe eine bekannte Werkzeugliste hat und die Reihenfolge in der Definition sichtbar ist.
- Grenzen: passt nur, wenn Sie die Schritte vorab benennen können. Hängt der Weg von Funden ab, wird eine Pipeline unhandlich.
Eine Entscheidungshilfe
Stellen Sie diese Fragen der Reihe nach und hören Sie beim ersten „Nein“ für ein Multi-Agenten-Design auf.
- Lässt sich die Aufgabe in unabhängige Teile zerlegen? Hängen Teilaufgaben vom Ergebnis der anderen ab, bringen zusätzliche Agenten Wartezeit und Koordination, keine Geschwindigkeit.
- Übersteigt die Breite ein Kontextfenster? Kann ein Agent das Material halten, teilen Sie nur auf, wenn Sie unterschiedliche Berechtigungen für die Teile brauchen.
- Ist der Wert hoch genug? Schätzen Sie Tokens pro Lauf je Entwurf und vergleichen Sie mit dem Wert einer richtigen Antwort. Ein Faktor zehn auf einer billigen Aufgabe ist weiter billig; bei hohem Volumen ist er ein Budgetposten.
- Lässt sich das Ergebnis prüfen? Zusammengeführte Ausgaben mehrerer Agenten brauchen eine Kontrolle: Tests, ein Schema, eine zweite Quelle. Was Sie nicht prüfen können, dessen zusätzlicher Komplexität können Sie nicht trauen.
- Lässt es sich steuern? Berechtigungen je Agent, Budgets je Lauf und ein Trace über die Übergaben müssen existieren, bevor Sie Agenten hinzufügen.
Lautet die Antwort auf die erste Frage „Nein“ oder ist die Aufgabe ein gerader Ablauf, schlagen Workflows offene Agenten aus demselben Grund: Eine feste Reihenfolge ist billiger und vorhersehbarer, als wenn ein Modell Schritte wählt.
Praktische Regeln, wenn es doch Multi-Agent sein soll
- Dem Lead ein Budget geben und jedem Worker einen Anteil. Ein unbegrenztes Auffächern ist neben dem Kostenproblem auch eine Denial-of-Wallet-Schwachstelle.
- Tiefe und Auffächerung begrenzen. Worker, die Worker starten, brauchen eine ausdrückliche Grenze.
- Werkzeuge je Worker begrenzen. Ein Such-Worker braucht Suche, keinen Schreibzugriff. Der Lead sollte nicht alles erben.
- Strukturierte Ergebnisse zurückgeben. Verlangen Sie von Workern benannte Felder und Quellen statt Prosa, damit der Zusammenführungsschritt Aussagen vergleichen kann.
- Über Agenten hinweg tracen. Eine Lauf-ID, die Lead und Worker verbindet, ermöglicht Fehlersuche im Nachhinein.
- Zuerst die Einzelagenten-Basislinie testen. Löst ein Agent mit besseren Werkzeugen die Aufgabe, haben Sie viel Geld gespart.
Wichtigste Punkte
- Multi-Agenten-Entwürfe kaufen Breite mit Tokens; das veröffentlichte Verhältnis von rund 15× gegenüber Chat ist die Zahl eines Teams, aber die Richtung gilt.
- Benchmark-Gewinne von Multi-Agenten-Aufbauten sind oft klein, messen Sie deshalb gegen eine Einzelagenten-Basislinie.
- Der Einzelagent ist am billigsten und am leichtesten zu steuern, Orchestrator-Worker am breitesten und teuersten, die Pipeline vorhersehbar und passend für bekannte Schritte.
- Fehler entstehen an Übergaben: typisierte Verträge, Budgets, Tiefenlimits und Berechtigungen je Worker.
Quellen
- Anthropic, How we built our multi-agent research system (2025).
- arXiv, Why Do Multi-Agent LLM Systems Fail? (2025).
- Anthropic, Create custom subagents (Claude Code docs) (Live-Dokumentation).