Die Sicherheits-Prüfliste für Agenten: zwanzig Fragen vor der Produktion
KI-Agenten Sicherheits-Checkliste: zwanzig Ja/Nein-Fragen zu Identität, Rechten, Datenfluss, Injection, Sandbox, Lieferkette und Audit mit Links zur Vertiefung.
Dieser Beitrag ist auch auf English verfügbar.
Bevor ein Agent in Produktion geht, sollten sich zwanzig Fragen beantworten lassen. Ist eine Antwort “nein” oder “wissen wir nicht”, dann ist genau das die Aufgabe. Diese Sicherheits-Prüfliste für KI-Agenten fasst die Sicherheitsbeiträge dieses Blogs in sieben Bereichen zusammen: Identität, Rechte, Datenfluss, Injection, Sandbox, Lieferkette und Audit. Sie ist ein Bedrohungsmodell in Frageform, keine Zertifizierung, und sie ersetzt keine Prüfung durch jemanden, der Ihre Umgebung kennt.
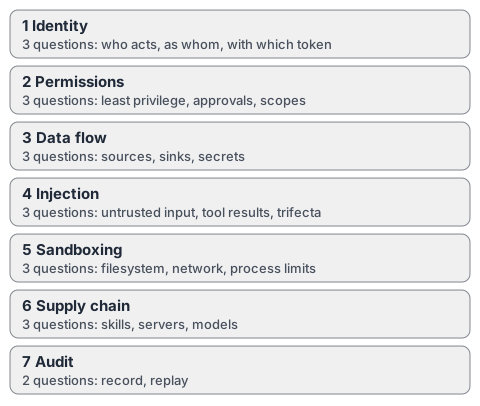
So wird sie benutzt: Liste ausdrucken, jede Frage je Agent (nicht je Plattform) beantworten und den Nachweis danebenschreiben, etwa eine Konfigurationsdatei, eine Policy-Regel oder eine Log-Abfrage. “Wahrscheinlich” zählt als “nein”.
1. Identität
- Läuft jeder Agent unter einer eigenen Identität? Gemeinsame Servicekonten machen unklar, welcher Agent was getan hat. Eine Identität je Agent und je Umgebung.
- Ist klar, in wessen Auftrag der Agent handelt? Ein Agent, der für einen Nutzer handelt, darf höchstens dessen Befugnisse haben. Agent und Nutzer gehören in jeden Aufruf-Eintrag.
- Sind Tokens kurzlebig und auf eine Zielgruppe (Audience) begrenzt? Ein für einen Server ausgestelltes Token darf bei einem anderen nicht funktionieren. Die MCP-Spezifikation ist hier eindeutig:
MCP servers MUST NOT accept any tokens that were not explicitly issued for the MCP server.
Quelle: Security Best Practices, MCP 2025-06-18. Sinngemäß: MCP-Server dürfen nur Tokens akzeptieren, die ausdrücklich für sie ausgestellt wurden. Dieselbe Seite sagt auch, wofür Sessions nicht taugen:
MCP Servers MUST NOT use sessions for authentication.
Sinngemäß: Sessions dürfen nicht zur Authentifizierung dienen. Den Ablauf der Autorisierung beschreibt MCP-Autorisierung mit OAuth.
2. Rechte
- Hat jeder Agent nur die Werkzeuge, die sein Schritt braucht? Breite Agenten in kleine zerlegen, siehe minimale Rechte für Agenten.
- Sind Tool-Argumente eingeschränkt, nicht nur Tool-Namen? “Darf
add_commentaufrufen” ist schwach; “darf einen Kommentar mit höchstens 2000 Zeichen an Tickets nach dem MusterSEC-<Zahl>schreiben” ist eine prüfbare Regel. - Brauchen unumkehrbare oder externe Aktionen eine Freigabe? Mailversand, Löschen, Zahlungen und Veröffentlichungen sollten auf eine Person mit passender Rolle warten.
3. Datenfluss
- Lässt sich zeichnen, wo Daten in einen Agenten hinein- und herausfließen? Quellen, Senken und das Vertrauensniveau jeder Stelle. Was sich nicht zeichnen lässt, lässt sich nicht auf Lecks prüfen.
- Bleiben Geheimnisse aus Prompts und Tool-Ergebnissen heraus? Zugangsdaten gehören in die Tool-Schicht, nicht in den Kontext des Modells. Die MCP-Spezifikation verbietet außerdem, per Elicitation sensible Daten abzufragen (siehe MCP Sampling, Elicitation und Tasks).
- Gibt es eine Regel, was die Organisation verlassen darf? Ausgehende Domains, Anhänge und an Dritte gesendete Logs brauchen eine ausdrückliche Allowlist.
4. Injection
- Gilt jeder externe Text als nicht vertrauenswürdig? Webseiten, Tickets, E-Mails und Tool-Ergebnisse können Anweisungen enthalten. Das Modell kann Daten und Befehle nicht zuverlässig trennen.
- Vereint ein einzelner Agent private Daten, nicht vertrauenswürdige Inhalte und einen ausgehenden Kanal? Diese Kombination beschreibt das tödliche Trio. Ein Bein entfernen.
- Steht ein deterministisches Gate zwischen Modellausgabe und Seiteneffekten? Das Modell schlägt vor, die Policy entscheidet; siehe Policy entscheidet, Audit beweist. Die Dokumentation von Claude Code sagt es nüchtern:
Servers that fetch external content can expose you to prompt injection risk.
Quelle: Connect Claude Code to tools via MCP (Live-Dokumentation, Wortlaut Stand 2026-10-04). Sinngemäß: Server, die externe Inhalte laden, können für Prompt Injection anfällig machen.
5. Sandbox
- Läuft Codeausführung in einer Sandbox ohne ständig vorhandene Zugangsdaten? Kein Home-Verzeichnis, kein Cloud-Metadaten-Endpunkt, keine vererbten Umgebungsvariablen.
- Ist ausgehender Netzverkehr standardmäßig gesperrt? Nur benannte Hosts erlauben. Siehe Agenten in der Sandbox.
- Sind CPU, Speicher, Zeit und Kosten je Lauf begrenzt? Ein Agent in einer Schleife sollte an eine Obergrenze stoßen, bevor er Ihre Rechnung erreicht.
6. Lieferkette
- Kennen Sie jeden MCP-Server und jeden Skill, den ein Agent laden kann, und wer dafür zuständig ist? Dieselbe Dokumentation formuliert die Regel in einer Zeile:
Verify you trust each server before connecting it.
Auf Deutsch: Vor dem Verbinden prüfen, ob man dem Server vertraut.
- Sind Versionen festgelegt und Änderungen geprüft? Ein Server oder Skill, der sich unbemerkt ändert, ist eine neue, ungeprüfte Abhängigkeit.
- Wissen Sie, welches Modell und welcher Anbieter welche Daten verarbeitet? Dazu gehören Region, Aufbewahrung und das Ausweichmodell bei Ausfall.
7. Audit
- Wird jeder Tool-Aufruf mit Argumenten, Entscheidung und handelnder Identität festgehalten? Ein einfaches Log ist ein Anfang; ein nur anhängbares, manipulationssicheres Protokoll ist besser.
- Lässt sich ein Agent stoppen und nachvollziehen, was er getan hat? Ein Not-Aus und ein wiederabspielbares Protokoll sind das Minimum für die Reaktion auf Vorfälle.
Zuordnung zur OWASP-Liste
Die Prüfliste kopiert keinen Standard. Wer sie zuordnen muss, findet in den OWASP Top 10 for Agentic Applications for 2026 die naheliegende Referenz. Das Dokument beschreibt sich so:
identifies the most critical security risks facing autonomous and agentic AI systems.
Sinngemäß: Es benennt die kritischsten Sicherheitsrisiken autonomer und agentischer KI-Systeme. Einen Durchgang durch die Liste bietet die OWASP-Top-10 für agentische Anwendungen. Für Begriffe rund um Angriffe und Gegenmaßnahmen ist die Taxonomie zu Adversarial Machine Learning des NIST ein nützliches Vokabular:
provides a taxonomy of concepts and defines terminology in the field of adversarial machine learning (AML).
Beispiel einer Policy-Entscheidung
In der aktuellen Demo zeigt eine Policy-Entscheidung das angefragte Tool, seine Argumente, die passende Regel und das Ergebnis, etwa “Freigabe erforderlich” für einen Schreibzugriff auf ein Beispiel-Ticket. Genau diese Form verlangt Frage 12: sichtbare Regel, sichtbare Entscheidung, kein Ermessen des Modells.
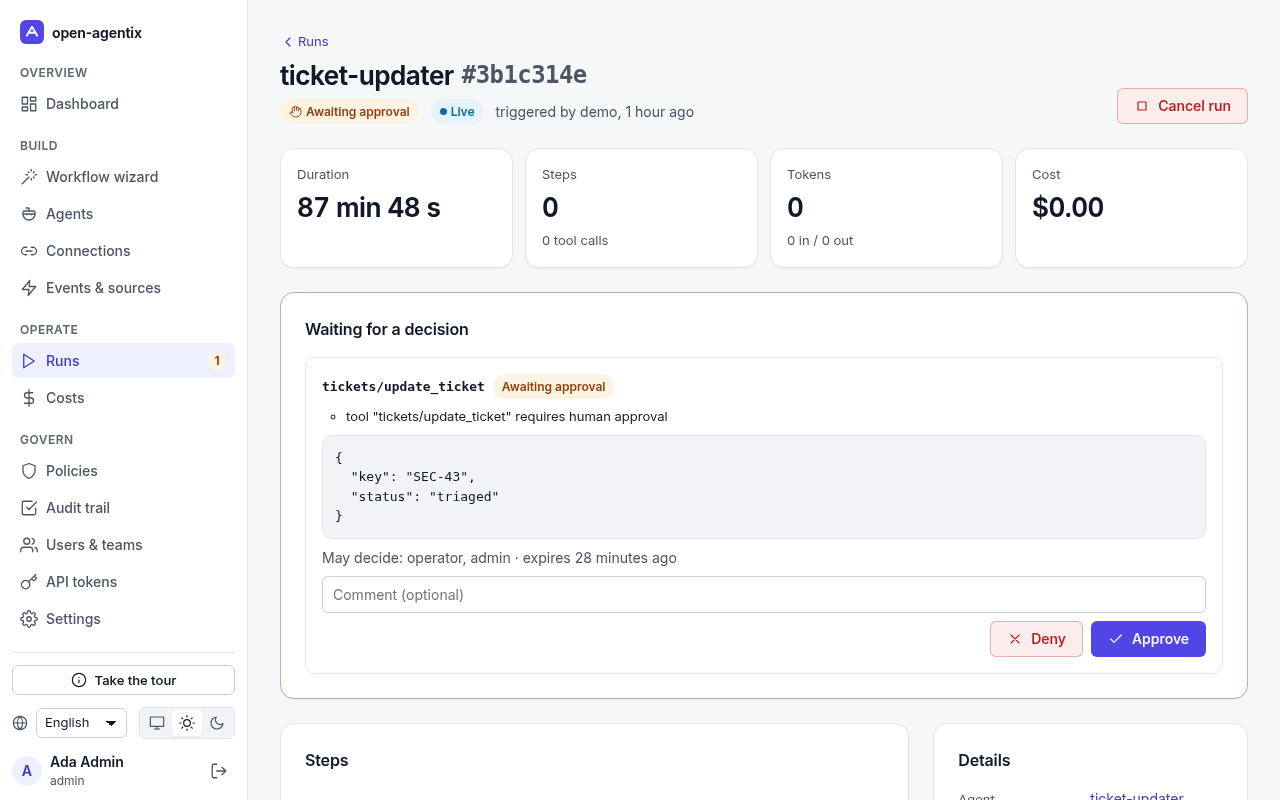
Screenshot der aktuellen Demo (erfundene Daten).
Auswertung und nächste Schritte
Zählen Sie die Antworten, die Sie mit einem Nachweis belegen können. Unter fünfzehn ist der Agent ein Pilot, kein Produktionsdienst. Zuerst die Fragen 6, 11 und 12 angehen: Sie begrenzen den Schaden bei Fehlern, die sich nicht vorhersagen lassen. Danach die Prüfung wiederholen, sobald sich Tools, Skills oder Modelle ändern; eine einmal beantwortete Liste ist nur eine Momentaufnahme.
Das Wichtigste in Kürze
- Zwanzig Fragen in sieben Bereichen: Identität, Rechte, Datenfluss, Injection, Sandbox, Lieferkette, Audit.
- Je Agent beantworten und Nachweise aufbewahren; “wahrscheinlich” heißt “nein”.
- Am meisten bringen strukturelle Maßnahmen: ein Bein des Trios entfernen, Seiteneffekte absichern, ausgehenden Verkehr sperren.
- Die Liste erneut durchgehen, wenn sich ein Tool, Skill, Server oder Modell ändert.
Quellen
- OWASP Gen AI Security Project, OWASP Top 10 for Agentic Applications for 2026, veröffentlicht am 09.12.2025.
- Model Context Protocol, Security Best Practices (2025-06-18).
- NIST, AI 100-2 E2025, Adversarial Machine Learning, veröffentlicht am 24.03.2025.
- Anthropic, Connect Claude Code to tools via MCP, Live-Dokumentation.