Ein Architektur-Review für Agentensysteme auf einer Seite
KI-Architektur-Review für Agenten auf einer Seite: Zweck, Grenzen, Datenfluss, Verträge, Autonomie und Fehlerpfade, mit Leitfragen für die Prüfung.
Dieser Beitrag ist auch auf English verfügbar.
Ein einseitiges KI-Architektur-Review fängt die meisten Entwurfsfehler ab, bevor ein Agent live geht, denn die wenigsten dieser Fehler betreffen das Modell. Es geht um unklare Grenzen, undefinierte Übergaben, Daten, die dorthin fließen, wo es niemand eingezeichnet hat, und Fehlerpfade, die niemand durchgespielt hat. Dieser Beitrag liefert eine Vorlage mit sieben Abschnitten, die Fragen je Abschnitt und eine Form, das Ergebnis festzuhalten, damit das Review ein Artefakt bleibt und keine vergessene Besprechung.
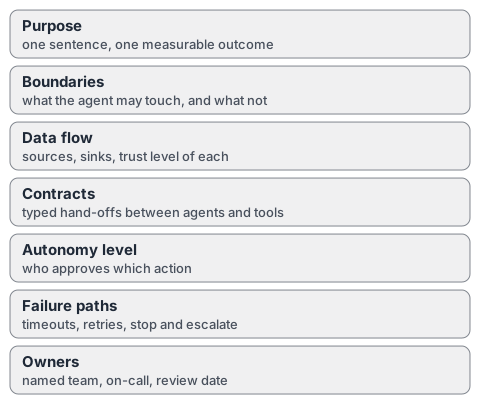
Nutzen Sie die Vorlage als Gesprächsleitfaden von 45 bis 60 Minuten mit den Menschen, die das System gebaut haben, und mindestens einer Person, die es nicht gebaut hat. Eine Seite erzwingt Entscheidungen; braucht ein Abschnitt drei Seiten, ist das der Befund.
Mit dem Einfachsten beginnen, das funktioniert
Die Anleitung von Anthropic zum Bau von Agenten plädiert für Zurückhaltung:
Consistently, the most successful implementations use simple, composable patterns rather than complex frameworks.
Quelle: Building Effective AI Agents, Anthropic, 19.12.2024 (die Seite wurde seither aktualisiert; der Satz stammt aus dem Kerntext). Sinngemäß: Die erfolgreichsten Umsetzungen nutzen einfache, kombinierbare Muster statt komplexer Frameworks.
Derselbe Artikel trennt zwei Arten von Systemen:
Workflows are systems where LLMs and tools are orchestrated through predefined code paths.
Sinngemäß: Workflows sind Systeme, in denen LLMs und Tools über vorab festgelegte Codepfade orchestriert werden. Alles, bei dem das Modell seine Schritte selbst lenkt, sind Agenten. Ein Review beginnt mit der Frage, was Sie bauen und warum; siehe Workflows und Agenten. Genügt ein fester Workflow, wird das Review kürzer, weil der Kontrollfluss Code ist, den man lesen kann.
Multi-Agenten-Entwürfe verdienen zusätzliche Skepsis. Eine Studie zu Fehlern solcher Systeme beginnt mit einer nüchternen Beobachtung:
Despite enthusiasm for Multi-Agent LLM Systems (MAS), their performance gains on popular benchmarks are often minimal.
Quelle: Why Do Multi-Agent LLM Systems Fail?, arXiv (erstmals 17.03.2025 veröffentlicht; das Zitat stammt aus dem Abstract der neuesten Version). Sinngemäß: Trotz der Begeisterung für Multi-Agenten-Systeme sind deren Leistungsgewinne auf gängigen Benchmarks oft gering.
Das spricht nicht gegen Zerlegung aus Sicherheitsgründen, wie in minimale Rechte für Agenten. Es ist ein Grund zu fragen, was jeder zusätzliche Agent bringt.
Die einseitige Vorlage
1. Zweck
Ein Satz dazu, was das System tut, und ein messbares Ergebnis. Wer das Ergebnis nicht aufschreiben kann, kann später nicht beurteilen, ob das System funktioniert. Hintergrund in Architektur vor Prompts.
Fragen: Wer ist der Nutzer? Was passiert, wenn das System nichts tut? Was liegt ausdrücklich außerhalb des Umfangs?
2. Grenzen
Was das System berühren darf und was nicht: Tools, Systeme, Datenklassen, Netze, Mandanten. Einen Kasten zeichnen und auflisten, was ihn überquert.
Fragen: Welche Zugangsdaten hält jede Komponente? Wie groß ist der Wirkungsradius der schlimmsten Einzelkomponente? Welche Teile stammen von Dritten?
3. Datenfluss
Quellen, Senken und das Vertrauensniveau jeder Stelle. Markieren, wo nicht vertrauenswürdiger Text in den Kontext des Modells gelangt und wo Ausgaben das System verlassen. Die Methode beschreibt Datenfluss zuerst.
Fragen: Wohin gehen personenbezogene oder vertrauliche Daten? Kann ein Pfad private Daten, nicht vertrauenswürdige Eingaben und einen ausgehenden Kanal verbinden? Wo werden Daten gespeichert, und wie lange?
4. Verträge
Typisierte Schnittstellen zwischen Agenten und Tools: Eingaben, Ausgaben, Fehler, Limits. Eine Übergabe in freiem Text ist ein Vertrag, den niemand testen kann; siehe Schnittstellenverträge für Agenten.
Fragen: Ist jede Übergabe ein Schema? Wer validiert sie, und was passiert bei einem Verstoß? Sind Tool-Argumente eingeschränkt?
5. Autonomiestufe
Wer was entscheidet. Jede Aktion als automatisch, von einer Person freigegeben oder verboten markieren. Unumkehrbare und von außen sichtbare Aktionen sollten nicht standardmäßig automatisch laufen.
Fragen: Welche Aktionen brauchen eine Freigabe, von wem, binnen welcher Zeit? Was tut das System währenddessen? Kann ein Mensch übernehmen?
6. Fehlerpfade
Für jede externe Abhängigkeit und jeden Schritt: Zeitlimit, Wiederholungsgrenze, Rückfall und was der Nutzer sieht. Das Modell eingeschlossen: Ausfall des Anbieters, Rate Limits, eine Ablehnung, eine fehlerhafte Antwort.
Fragen: Was stoppt eine Schleife? Wie hoch sind die Kosten eines Laufs höchstens? Wie wird das System angehalten, und woran erkennt man, dass es angehalten ist?
7. Verantwortliche
Ein benanntes Team für das System, für jedes Tool und jeden Skill, dazu Bereitschaft, Prüfdatum und der Ort, an dem Entscheidungen festgehalten werden.
Fragen: Wer wird alarmiert? Wer darf Prompts, Skills und Modelle ändern, und mit welcher Prüfung?
Entscheidungen festhalten, nicht nur Meinungen
Das Ergebnis des Reviews ist eine kurze Liste von Entscheidungen mit Begründung. Halten Sie sie als Architecture Decision Records im Repository fest: Titel, Kontext, Entscheidung, Folgen, Datum. Ändert sich der Agent, zeigt der ADR, was entschieden wurde und warum, und das ist nützlicher als ein Diagramm, das sich vom Stand entfernt hat.
Zusammenspiel mit Leitlinien für sichere Entwicklung
Wer bereits Leitlinien für sichere Entwicklung befolgt, ordnet das Review dort ein. Die Leitlinien des britischen NCSC gliedern sich in vier Bereiche:
four key areas within the AI system development life cycle: secure design, secure development, secure deployment, and secure operation and maintenance
Quelle: Guidelines for secure AI system development, UK National Cyber Security Centre, 27.11.2023. Sinngemäß: vier Schlüsselbereiche im Lebenszyklus eines KI-Systems, nämlich sicherer Entwurf, sichere Entwicklung, sichere Bereitstellung und sicherer Betrieb samt Wartung.
Die Abschnitte 1 bis 5 der Vorlage gehören überwiegend zum sicheren Entwurf; Abschnitt 6 liegt zwischen Bereitstellung und Betrieb; Abschnitt 7 ist Betrieb und Wartung. Wiederholen Sie das Review, wenn sich ein Tool, ein Modell oder eine Autonomiestufe ändert, nicht nur zum Start.
Ein Beispiel-Artefakt
Ein Übergabegraph ist ein guter Begleiter zur Seite: Agenten als Knoten, Übergaben als Kanten mit den Namen der Verträge. In der aktuellen Demo wird ein solcher Graph für einen Beispielprozess erzeugt, und das Review stellt an ihn dieselbe Frage wie an jedes Diagramm: Entspricht er dem, was tatsächlich läuft?
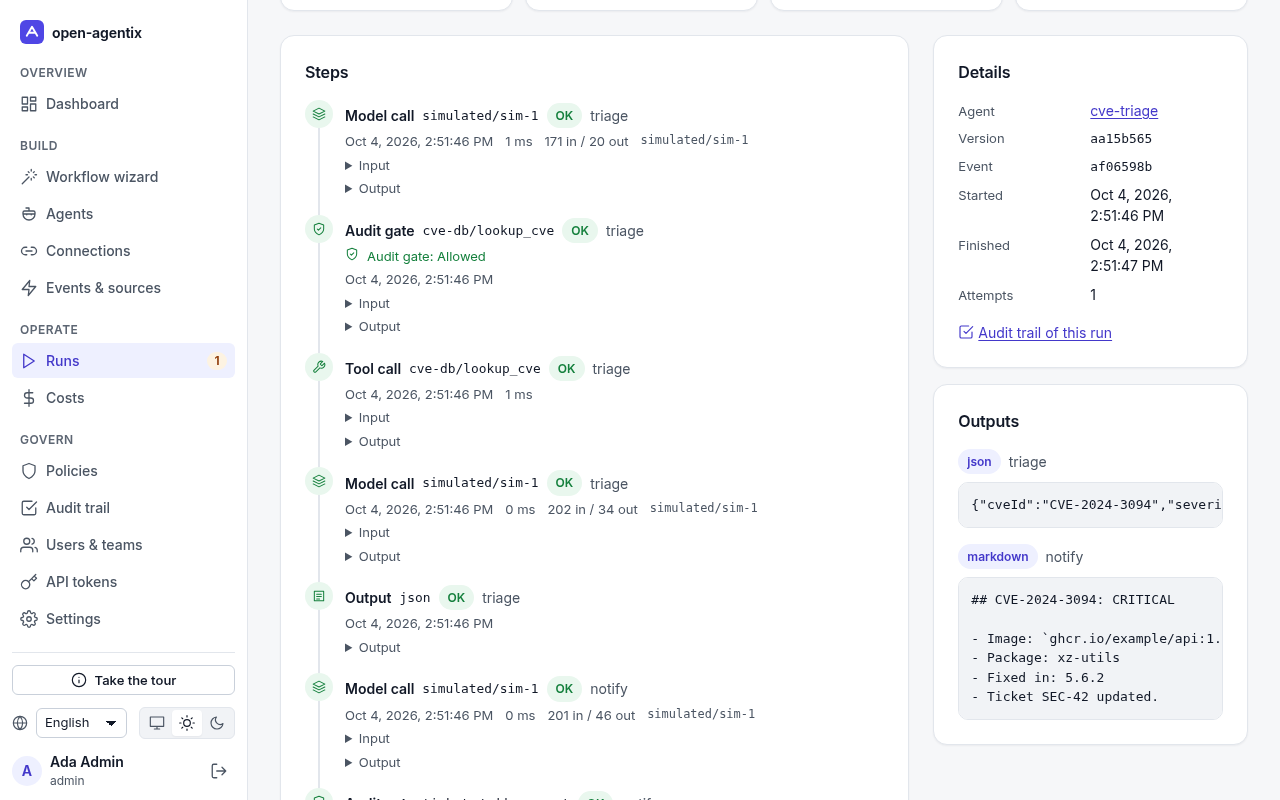
Screenshot der aktuellen Demo (erfundene Daten).
Das Wichtigste in Kürze
- Ein einseitiges Review zu Zweck, Grenzen, Datenfluss, Verträgen, Autonomie, Fehlerpfaden und Verantwortlichen fängt die meisten Entwurfsfehler ab.
- Mit der Frage beginnen, ob ein fester Workflow genügt; Agenten nur dort ergänzen, wo sie ihren Platz verdienen.
- Übergaben in freiem Text sind nicht testbare Verträge; Schemas verwenden.
- Entscheidungen als kurze ADRs festhalten und das Review wiederholen, wenn sich Tools, Modelle oder Autonomie ändern.
Quellen
- Anthropic, Building Effective AI Agents, 19.12.2024.
- arXiv, Why Do Multi-Agent LLM Systems Fail?, 2025.
- UK National Cyber Security Centre, Guidelines for secure AI system development, 27.11.2023.