LLM als Richter: nützlicher Bewerter mit bekannten Verzerrungen
LLM as a Judge skaliert Bewertung, hat aber Positions-, Längen- und Selbstbevorzugung. Welcher Bewerter passt und wie man ein Modell kalibriert.
Dieser Beitrag ist auch auf English verfügbar.
LLM as a Judge heißt, ein Modell die Ausgabe eines anderen bewerten zu lassen, und das ist nützlich, weil es dort skaliert, wo menschliche Prüfung nicht mitkommt. Es ist aber auch auf dokumentierte Weise verzerrt: Es kann die Antwort an einer bestimmten Position bevorzugen, längere Antworten bevorzugen und Antworten, die es selbst geschrieben hat. Die praktische Regel lautet: den billigsten Bewerter nehmen, der die Frage wirklich entscheiden kann, Modell-Bewerter für Urteile reservieren, die Code nicht fällen kann, und jeden Modell-Bewerter gegen menschliche Labels kalibrieren, bevor man seinen Werten traut. Dieser Beitrag erklärt die drei Bewertertypen, die bekannten Verzerrungen und eine Kalibrierungsroutine.
Was ein Bewerter ist
Evaluierung braucht etwas, das das Verhalten eines Agenten in einen Wert verwandelt. Der Leitfaden von Anthropic zu Agenten-Evaluierungen definiert es in einem Satz (englisches Originalzitat; sinngemäß: Ein Grader ist Logik, die einen Aspekt der Leistung des Agenten bewertet):
A grader is logic that scores some aspect of the agent’s performance.
Quelle: Anthropic, Demystifying evals for AI agents. „Logik“ ist das nützliche Wort. Ein Bewerter kann ein paar Zeilen Code sein, ein Prompt an ein Modell oder eine Person mit Bewertungsraster. Die Wahl sollte sich daraus ergeben, was Sie prüfen, nicht daraus, was gerade modern ist. Wer neu im Thema ist, findet in Agent-Evals 101 das Grundvokabular aus Aufgaben, Durchläufen und Bewertern.
Drei Bewertertypen
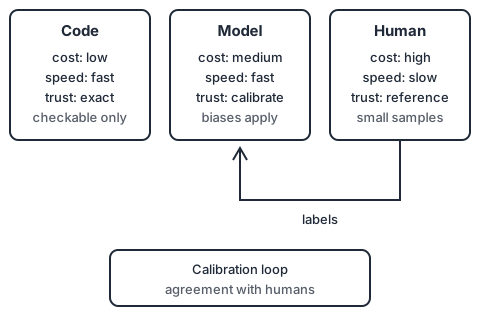
Code-Bewerter
Eine deterministische Prüfung: exakter Treffer, ein regulärer Ausdruck, eine Schema-Validierung, ein Unit-Test, eine Abfrage gegen das System, das der Agent verändert hat. Bei Agenten schauen die besten Bewerter oft auf das Ergebnis in der Umgebung statt auf das, was der Agent sagte. Derselbe Artikel von Anthropic nennt ein Beispiel (englisches Originalzitat; sinngemäß: Das Ergebnis ist, ob in der SQL-Datenbank der Umgebung eine Reservierung existiert):
the outcome is whether a reservation exists in the environment’s SQL database.
Diese Prüfung ist billig, sofort und exakt. Über sie lässt sich nicht streiten, und sie driftet nicht.
- Einsetzen, wenn: sich das richtige Ergebnis als Bedingung an Zustand oder Ausgabe formulieren lässt.
- Grenze: Sie misst nur, woran Sie zu prüfen dachten. Stil, Hilfsbereitschaft und Qualität der Argumentation sind meist außer Reichweite.
Modell-Bewerter (LLM as a Judge)
Ein Modell erhält Aufgabe, Ausgabe und Bewertungsraster und liefert einen Wert oder ein Urteil. Es kann offenen Text, Zusammenfassungen, Ton und Teilpunkte beurteilen und Begründungen lesen, die Code nicht parsen kann.
- Einsetzen, wenn: das Kriterium semantisch ist und sich nicht auf eine Regel reduzieren lässt.
- Grenze: Es ist selbst ein Modell, mit aller Streuung und Verzerrung, die das mit sich bringt.
Menschliche Bewerter
Eine Person liest und bewertet. Teuer und langsam, aber die Referenz für alles Subjektive und der einzige Weg zu erfahren, ob ein Modell-Bewerter etwas taugt.
- Einsetzen, wenn: Sie Modell-Bewerter kalibrieren, folgenreiche Ausgaben bewerten oder definieren, was „gut“ heißt.
- Grenze: Kosten, Latenz und Uneinigkeit zwischen Menschen.
Ein sinnvoller Aufbau: Code-Bewerter für alles Prüfbare, ein Modell-Bewerter für den semantischen Rest und eine kleine, regelmäßige menschliche Stichprobe, die beide ehrlich hält. Das Werkzeug nimmt Ihnen diese Entscheidung nicht ab. Ein offenes Evaluierungs-Framework wie Inspect beschreibt seinen Umfang so (englisches Originalzitat; sinngemäß: Inspect eignet sich für ein breites Spektrum von Evaluierungen zu Programmieren, agentischen Aufgaben, Schlussfolgern, Wissen, Verhalten und multimodalem Verständnis):
Inspect can be used for a broad range of evaluations that measure coding, agentic tasks, reasoning, knowledge, behavior, and multi-modal understanding.
Quelle: Inspect, UK AI Security Institute (Live-Dokumentation, Wortlaut Stand 2026-10-04). Ein solches Framework liefert die Laufumgebung für Bewerter; die Mischung aus Code-, Modell- und menschlichen Bewertern bleibt Ihr Entwurf.
Die bekannten Verzerrungen
Die Arbeit, die den Ansatz bekannt machte und Modellurteile mit menschlichen Präferenzen bei mehrstufigen Fragen und Chatbot-Duellen verglich, ist offen über ihre Grenzen (englisches Originalzitat; sinngemäß: Wir untersuchen Nutzung und Grenzen von LLM-as-a-Judge, darunter Positions-, Längen- und Selbstbevorzugungs-Verzerrung):
We examine the usage and limitations of LLM-as-a-judge, including position, verbosity, and self-enhancement biases
Quelle: Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (arXiv, 2023). Um diese drei Verzerrungen müssen Sie herumplanen.
- Positionsverzerrung. Beim paarweisen Vergleich bevorzugt der Richter die zuerst (oder zuletzt) gezeigte Antwort öfter, als er sollte. Gegenmittel: jeden Vergleich zweimal mit vertauschter Reihenfolge laufen lassen und nur konsistente Urteile zählen, inkonsistente als Unentschieden werten.
- Längenverzerrung. Längere Antworten bekommen unabhängig von der Qualität bessere Werte. Gegenmittel: im Raster festhalten, dass Länge keine Tugend ist, Länge und Wert in Ihren Daten gegenüberstellen und längenkontrollierte Vergleiche erwägen.
- Selbstbevorzugung (self-enhancement). Ein Modell bewertet eigene Ausgaben (oder die der eigenen Familie) tendenziell besser. Gegenmittel: einen Richter aus einer anderen Modellfamilie als der Generator nehmen, mindestens aber ein anderes Modell als das getestete.
In der Praxis treten weitere Effekte auf, die das Zitat nicht abdeckt: Empfindlichkeit gegenüber der Formulierung des Prompts, der verwendeten Skala (eine Zehnerskala lädt zu Rauschen ein) und oberflächlicher Formatierung. Behandeln Sie den Richter-Prompt wie Code, der Versionierung und Tests braucht.
So kalibrieren Sie einen Modell-Bewerter
Kalibrierung beantwortet eine Frage: Stimmt dieser Bewerter bei Fällen wie meinen oft genug mit Menschen überein, um nützlich zu sein? Die Routine ist kurz.
- Einen gelabelten Satz bauen. Nehmen Sie 50 bis 200 echte Ausgaben, die gute, schlechte und Grenzfälle abdecken, und lassen Sie mindestens zwei Personen sie mit demselben Raster labeln. Wo sie uneins sind, klären Sie das und schärfen das Raster.
- Das Raster als Kriterien formulieren. Bevorzugen Sie konkrete, prüfbare Aussagen („nennt für jede Behauptung eine Quelle“) gegenüber vagen („ist von hoher Qualität“). Nutzen Sie kleine Skalen, am besten bestanden/nicht bestanden je Kriterium.
- Erst die Begründung, dann den Wert verlangen. Lässt man den Richter zuerst eine kurze Begründung schreiben, werden Urteile meist konsistenter, und Sie haben etwas zum Prüfen.
- Den Richter auf dem gelabelten Satz laufen lassen. Messen Sie die Übereinstimmung mit Menschen mit einem zufallskorrigierten Maß wie Cohens Kappa, nicht nur als Rohprozent. Schauen Sie sich die Abweichungen an; sie zeigen, welche Kriterien der Richter falsch liest.
- Gezielt auf Verzerrung testen. Vertauschen Sie die Antwortreihenfolge, füllen Sie Antworten mit irrelevantem Text auf und vergleichen Sie die Ausgaben eines Modells mit denen anderer. Bewegen sich die Werte, obwohl die Qualität gleich blieb, haben Sie eine Verzerrung gefunden.
- Festnageln und überwachen. Halten Sie Richter-Modellversion und Prompt fest. Lassen Sie den gelabelten Satz bei jeder Änderung neu laufen und gelegentlich auch ohne Anlass, um Drift zu erkennen.
- Menschen in einer Stichprobenschleife halten. Prüfen Sie wöchentlich eine kleine Zufallsstichprobe der produktiven Bewertungen und führen Sie Abweichungen in den gelabelten Satz zurück.
Richter-Werte verantwortungsvoll nutzen
- Pro Kriterium bestanden/nicht bestanden statt eines Gesamtwerts. Das lässt sich leichter kalibrieren und umsetzen.
- Unsicherheit benennen. Der Wert eines Richters, der in 80 Prozent der Fälle mit Menschen übereinstimmt, ist ein Signal, keine Messung.
- Releases nicht an einer einzelnen Richterzahl festmachen, ohne menschliche Kontrolle, solange der Bewerter keine Bilanz hat. Die Qualitätsschranken für Agentenausgaben funktionieren am besten mit Code-Prüfungen als harten Schranken und Modellwerten als weicheren Signalen.
- An Service-Level koppeln. Wenn Sie sich auf ein Qualitätsziel festlegen, definieren Sie es auf Bewertern, denen Sie trauen; siehe SLOs für Agenten.
- Den Richter von Geheimnissen des Generators fernhalten. Der Richter sieht Ausgaben, keine Zugangsdaten oder privaten Kontext, den er nicht braucht.
Wichtigste Punkte
- Ein Bewerter ist nur Logik, die Verhalten bewertet; wählen Sie Code, Modell oder Mensch danach, was die Frage braucht.
- Nutzen Sie Code-Bewerter für alles Prüfbare, besonders für Ergebnisse in der Umgebung.
- LLM-Richter sind durch Position, Länge und Selbstbevorzugung verzerrt; Reihenfolge vertauschen, Länge kontrollieren und eine andere Modellfamilie nehmen.
- Gegen menschliche Labels kalibrieren, Übereinstimmung messen und bei Änderung von Richter oder Prompt neu kalibrieren.
- Behandeln Sie Richter-Werte als Signale mit Unsicherheit, nicht als Wahrheit.
Quellen
- arXiv, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (2023).
- Anthropic, Demystifying evals for AI agents (2026).
- UK AI Security Institute, Inspect (Live-Dokumentation).