Agent-Evals 101: Aufgaben, Grader und Transkripte
KI-Agenten bewerten heißt, das Ergebnis in der Umgebung zu prüfen, nicht nur die Antwort. Aufgaben, Trials, Grader, Transkripte und pass@k gegen pass^k.
Dieser Beitrag ist auch auf English verfügbar.
Die Bewertung von KI-Agenten (AI agent evaluation) bedeutet, einen Agenten auf definierten Aufgaben mehrfach laufen zu lassen und zu bewerten, was in der Umgebung tatsächlich passiert ist, nicht nur, was der Agent am Ende gesagt hat. Ein Chatbot-Eval vergleicht eine Antwort mit einer Referenz. Ein Agent-Eval muss Nebenwirkungen prüfen: Wurde die Datei geändert, existiert die Zeile, wurde das richtige Ticket angelegt, und wurden verbotene Aktionen vermieden? Dieser Beitrag klärt die Begriffe und zeigt ein Minimal-Setup, das sich an einem Tag aufbauen lässt.
Das Vokabular
Wenige Begriffe decken die meisten Agent-Evals ab.
- Aufgabe (Task): ein Testfall mit Eingabe, Umgebung und Erfolgsbedingung.
- Trial: ein Versuch des Agenten an einer Aufgabe. Agenten sind nicht deterministisch, deshalb braucht eine Aufgabe meist mehrere Trials.
- Transkript: die vollständige Aufzeichnung eines Trials: Nachrichten, Tool-Aufrufe, Ergebnisse, Endantwort.
- Grader: die Logik, die einen Trial bewertet.
- Umgebungszustand: was nach dem Trial in der Welt gilt, etwa Datenbankzeilen oder Dateien.
- Score: das Aggregat über Grader und Trials.
Das Entwicklerteam von Anthropic definiert den Grader in einem Satz (Zitate im englischen Original):
A grader is logic that scores some aspect of the agent’s performance.
Demystifying evals for AI agents (Anthropic, 2026)
Sinngemäß: Ein Grader ist Logik, die einen Aspekt der Leistung des Agenten bewertet. Beachten Sie „einen Aspekt“: Ein Trial hat meist mehrere Grader, die je eine andere Eigenschaft prüfen.
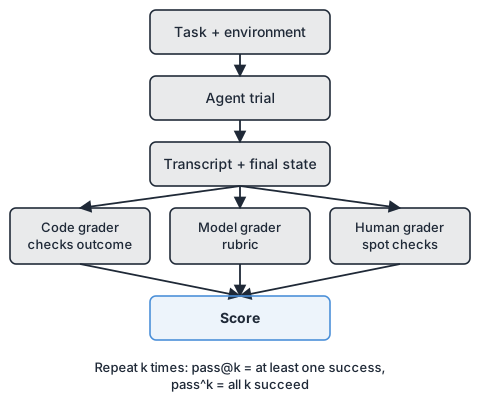
Das Ergebnis bewerten, nicht die Nachricht
Ein Agent, der „Ich habe Ihren Flug gebucht“ sagt, hat nicht zwingend einen Flug gebucht. Die verlässliche Prüfung schaut in die Welt. Derselbe Artikel veranschaulicht das an einem Buchungsszenario:
the outcome is whether a reservation exists in the environment’s SQL database.
Demystifying evals for AI agents (Anthropic, 2026)
Sinngemäß: Das Ergebnis ist, ob in der SQL-Datenbank der Umgebung eine Reservierung existiert. Übertragen Sie das auf die eigenen Aufgaben. Soll der Agent einen Pull Request öffnen, fragen Sie das Repository ab. Soll er ein Ticket anlegen, lesen Sie den Tracker. Soll er ein System nicht anfassen, prüfen Sie, dass es unverändert ist. Das Transkript bleibt wertvoll, aber als Beleg für die Fehlersuche und für die Bewertung, wie der Agent gearbeitet hat (etwa ob er ein verbotenes Tool aufrief), nicht als Hauptsignal für Erfolg.
Drei Arten von Gradern
| Grader | Geeignet für | Achtung |
|---|---|---|
| Code | Zustandsprüfungen, Schema-Validierung, bestandene Tests, Erkennung verbotener Aufrufe | Fragil, wenn er Wortlaut statt Ergebnis prüft |
| Modell (LLM) | Beurteilung von Textqualität, Ton und Vollständigkeit nach Rubrik | Muss gegen menschliche Bewertungen kalibriert werden; kann verzerrt oder inkonsistent sein |
| Mensch | Kalibrierung der anderen Grader, mehrdeutige oder folgenreiche Fälle | Langsam und teuer; Stichproben statt alles |
Bevorzugen Sie Code-Grader überall dort, wo sich das Ergebnis deterministisch prüfen lässt. Nutzen Sie einen LLM-Grader mit expliziter Rubrik, wo Urteil unvermeidbar ist, und kontrollieren Sie ihn stichprobenartig mit Menschen, damit Sie wissen, ob seine Scores Ihren folgen. Lassen Sie ein Modell nie ohne Rubrik und unabhängige Gegenprüfung seine eigene Arbeit bewerten.
Eine minimale Aufgabendefinition
Halten Sie Aufgaben in der Versionsverwaltung, neben der Agentendefinition, die sie testen:
id: refund-small-order
input: "Customer asks for a refund on order 1042 (EUR 19.90)."
environment: fixtures/shop-seed.sql
graders:
  - type: code
    check: "refunds table has one row for order 1042 with amount 19.90"
  - type: code
    check: "no call to tool payments.refund_large"
  - type: model
    rubric: "Reply is polite, states the refund amount, promises no timeline"
trials: 5
Beginnen Sie mit 10 bis 20 Aufgaben aus echten Fehlern und echten Anfragen. Nehmen Sie negative Aufgaben auf, bei denen richtiges Verhalten Ablehnen oder Nachfragen heißt. Ein Eval, das nur Erfolgsfälle enthält, belohnt Agenten, die nie Nein sagen.
Verlässlichkeit: pass@k gegen pass^k
Weil Trials streuen, genügt eine Zahl nicht. Zwei Aggregate beantworten unterschiedliche Fragen:
- pass@k: die Wahrscheinlichkeit, dass mindestens einer von k Trials gelingt. Es misst Fähigkeit: Kann der Agent das überhaupt, wenn er ein paar Versuche hat?
- pass^k: die Wahrscheinlichkeit, dass alle k Trials gelingen. Es misst Verlässlichkeit: Kann man sich jedes Mal darauf verlassen?
Die Kennzahl pass^k stammt aus dem τ-bench-Paper zu Agenten mit Werkzeugen:
We also propose a new metric (pass^k) to evaluate the reliability of agent behavior over multiple trials.
τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains (arXiv, 2024)
Sinngemäß: Eine neue Kennzahl (pass^k) bewertet die Verlässlichkeit des Agentenverhaltens über mehrere Trials. Gelingt eine Aufgabe pro Trial in 80 % der Fälle und sind die Trials unabhängig, ist pass@3 hoch, pass^3 aber nur rund 51 % und pass^8 etwa 17 %. Für einen kundennahen Prozess, der tausendfach läuft, passt pass^k zu dem, was Nutzer erleben. Verwenden Sie pass@k zum Erkunden und pass^k als Freigabekriterium.
Öffentliche Benchmarks und eigene Evals
Öffentliche Benchmarks eignen sich zum Vergleich von Modellen, und ihre Autoren begründen, warum eine realistische Aufgabenquelle zählt. Das SWE-bench-Paper formuliert es so:
We find real-world software engineering to be a rich, sustainable, and challenging testbed for evaluating the next generation of language models.
SWE-bench: Can Language Models Resolve Real-World GitHub Issues? (arXiv, 2023)
Sinngemäß: Reale Softwareentwicklung ist eine reichhaltige, nachhaltige und anspruchsvolle Testumgebung für Sprachmodelle. Die Lehre für eigene Evals betrifft die Datenquelle: echte Issues statt erfundener Rätsel. Ein öffentlicher Score sagt nicht, ob Ihr Agent mit Ihren Tools und Ihren Policies Ihre Tickets bewältigt. Bauen Sie eine private Suite aus der eigenen Historie und halten Sie sie aktuell, wenn sich der Prozess ändert.
Evals als Teil des Harness
Evals gehören in den Agent-Harness, nicht in ein Notebook: Der Harness setzt die Umgebung zurück, führt die Trials aus, speichert Transkripte und macht Freigaben von den Scores abhängig. Die umgebenden Bausteine beschreibt Was ist ein Agent-Harness. Ändert sich ein Prompt oder Skill, sollte die Eval-Suite laufen, bevor die Änderung ausgeliefert wird. Das ist auch das Mittel gegen die Gewohnheit aus Prompt-Wildwuchs und KI-Schlamperei, bei der Prompts wachsen, ohne dass etwas prüft, ob sie helfen. Eine saubere Struktur, wie in Architektur vor Prompts begründet, erleichtert auch Evals, weil jede Komponente einen testbaren Vertrag hat.
Häufige Fehler
- Nur die Endnachricht bewerten, sodass Nebenwirkungen ungeprüft bleiben.
- Ein Trial pro Aufgabe und eine einzige Erfolgsquote.
- Fixtures, die die Antwort in der Umgebung verraten.
- Modell-Grader ohne Rubrik oder menschliche Kalibrierung.
- Aufgaben nie ausmustern, die jede Version besteht; sie sagen nichts mehr aus.
Das Wichtigste in Kürze
- Bewerten Sie den Zustand der Umgebung nach dem Lauf; das Transkript ist Indiz, kein Beweis.
- Zuerst Code-Grader, dann Modell-Grader mit Rubrik, Menschen zur Kalibrierung.
- Mehrere Trials fahren; pass@k für Fähigkeit, pass^k für Verlässlichkeit berichten.
- Aufgaben aus echten Anfragen und Fehlern bauen, auch solche, bei denen der Agent ablehnen soll.
- Die Suite im Harness vor jeder Änderung an Prompt, Skill oder Policy laufen lassen.
Quellen
- Demystifying evals for AI agents, Anthropic, 09.01.2026.
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, arXiv, 2024.
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, arXiv, 2023.