Zu viele Prompts: wie Prompt-Wildwuchs zu KI-Ausschuss wird
AI Slop ist Ausgabe, die schneller wächst, als jemand sie prüfen kann. Wie Prompt-Wildwuchs die Qualität senkt und warum kleine, geprüfte Schritte besser sind.
Dieser Beitrag ist auch auf English verfügbar.
„AI Slop“ ist Ausgabe, die fertig aussieht und nicht geprüft wurde: Code, den niemand gelesen hat, Zusammenfassungen, die niemand verifiziert hat, Dokumente, die selbstsicher klingen und von den Fakten abdriften. Selten kommt das von einem einzelnen schlechten Prompt. Es kommt von Prompt-Wildwuchs: der Gewohnheit, jedes Problem mit einem weiteren Prompt, einem weiteren Agentenlauf oder einem weiteren Absatz Anweisungen zu beantworten, bis die erzeugte Menge schneller wächst, als irgendjemand sie prüfen kann. Dieser Beitrag ist eine Meinung, und er sagt, wo die Belege dünn sind. Das Argument: Der eigentliche Engpass ist Prüfkapazität, also sollte man auf weniger, kleinere, geprüfte Schritte hin entwerfen.
Wie Wildwuchs entsteht
Es beginnt vernünftig. Ein Agent übersieht einen Randfall, also kommt ein Satz in den Prompt. Ein zweiter Agent soll den ersten gegenprüfen. Ein dritter fasst beide zusammen. Jeder Schritt ist lokal sinnvoll. Nach Wochen bleibt ein Haufen: ein langer Dauer-Prompt, überlappende Anweisungen, die sich in Randbereichen widersprechen, und eine Pipeline, in der niemand sagen kann, welcher Schritt für welche Qualitätseigenschaft zuständig ist.
Drei Effekte verstärken sich.
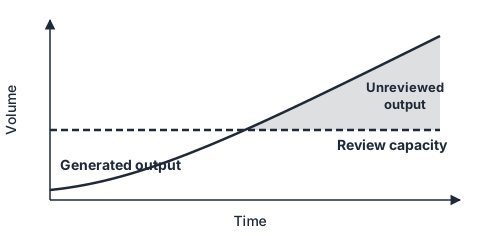
- Das Ausgabevolumen steigt. Mehr Läufe, mehr Entwürfe, mehr Diffs und mehr generierte Tests, weil Erzeugen billig ist.
- Die Prüfkapazität steigt nicht. Ein Mensch liest in Menschengeschwindigkeit. Wie viele Änderungen ein Team täglich ordentlich prüfen kann, bewegt sich kaum, wenn die Werkzeuge besser im Erzeugen werden.
- Der Kontext wird verrauscht. Lange Prompts mit überlappenden Regeln verwässern das Signal, das das Modell braucht.
Die Lücke zwischen den ersten beiden ist der stille Teil. Niemand beschließt, nicht mehr zu prüfen. Die Warteschlange wird länger, Reviews werden kürzer, und „sieht gut aus“ ersetzt „geprüft“.
Was die Belege sagen und was nicht
Bei Zahlen ist Vorsicht nötig. Im Juli 2025 veröffentlichte METR eine Studie zu erfahrenen Open-Source-Entwicklerinnen und -Entwicklern, die an ihren eigenen Repositories arbeiteten. Das Kernergebnis (Zitat im Original):
Surprisingly, we find that when developers use AI tools, they take 19% longer than without—AI makes them slower.
— METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity
Sinngemäß: Wer KI-Werkzeuge nutzte, brauchte 19 % länger. Zwei Einschränkungen sind wichtig. Erstens trägt die Seite inzwischen einen Hinweis, dass die Ergebnisse veraltet sind und eine Fortsetzung von 2026 existiert; es ist also eine Momentaufnahme der Werkzeuge von Anfang 2025, keine Aussage über heute. Zweitens ist es eine einzelne Studie zu einer bestimmten Gruppe und Situation. Sie ist eine Erinnerung daran, dass gefühlte und gemessene Geschwindigkeit auseinanderliegen können, kein Urteil über KI-Unterstützung.
Der DORA-Bericht 2025, zusammengefasst im Google-Cloud-Blog, trifft das Prüfproblem besser als jede Produktivitätszahl:
AI doesn’t fix a team; it amplifies what’s already there.
— Google Cloud, Announcing the 2025 DORA Report
Sinngemäß: KI repariert kein Team, sie verstärkt, was schon da ist. Ein Team mit guten Prüfgewohnheiten, kleinen Änderungen und guten Tests gewinnt mehr aus dem Erzeugen. Ein Team ohne sie bekommt schneller mehr Ausgabe unbekannter Qualität.
Warum mehr Prompts es verschlimmern
Anthropics Artikel zu Context Engineering nennt den Grund für die Prompt-Hälfte des Problems:
Context, therefore, must be treated as a finite resource with diminishing marginal returns.
— Anthropic, Effective context engineering for AI agents
und formuliert das Ziel:
good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.
— Anthropic, Effective context engineering for AI agents
Wildwuchs ist das Gegenteil: die größte Menge Token, überwiegend mit wenig Signal, Vorfall für Vorfall angehäuft. Die Lösung für einen wiederkehrenden Fehler ist selten ein weiterer Satz im Dauer-Prompt. Oft ist es ein engerer Schritt, eine deterministische Prüfung oder ein Skill, der nur für diese Aufgabe geladen wird. Der Beitrag Tool, Skill oder Prompt? hilft bei der Entscheidung, wohin eine Anleitung gehört.
Grundsätze für weniger, kleinere, geprüfte Schritte
- Prüfkapazität als Budget behandeln. Vor einem Schritt, der mehr erzeugt, fragen: Wer prüft das, und wie lange dauert es? Wenn niemand, den Schritt nicht hinzufügen.
- Schritte klein halten. Eine kleine Änderung kann jemand, der sie versteht, in Minuten prüfen. Eine große wird überflogen.
- Zuerst maschinell prüfen. Tests, Typprüfung, Linter, Schemavalidierung und Policy-Prüfungen sind billig und unermüdlich. Menschen sollten sehen, was die Maschinen bestanden hat.
- Ein Gate dem zweiten Modell vorziehen. Ein zweites Modell, das das erste prüft, erbt ähnliche blinde Flecken. Eine deterministische Prüfung nicht. Modell-Review als Ergänzung nutzen, nicht als einziges Gate.
- Erst streichen, dann hinzufügen. Wenn der Prompt wächst, etwas entfernen oder aufteilen. Selten gebrauchte Anweisungen in einen Skill verschieben, der bei Bedarf lädt.
- Verantwortung behalten. Jeder Prompt und jeder Pipeline-Schritt hat eine benannte Person, die gelegentlich die Ausgabe liest, nicht nur die Zusammenfassung.
- Ergebnis messen, nicht Menge. Nach dem Review gefundene Fehler, Prüfdauer und Nacharbeit verfolgen, nicht erzeugte Zeilen oder Dokumente.
Ein schneller Selbsttest fürs Team
- Wie viele KI-erzeugte Änderungen werden pro Woche gemergt, und wie viele wurden wirklich Zeile für Zeile gelesen?
- Ist der Dauer-Prompt im letzten Quartal gewachsen? Widerspricht sich etwas darin?
- Lässt sich für jeden bekannten Fehler die Prüfung benennen, die ihn fängt, außer dem Eindruck eines Menschen?
- Können Prüfende Nein sagen, ohne zum Flaschenhals zu werden?
- Ist bei Qualitätsverlust die erste Reaktion ein neuer Prompt oder ein Blick auf die Pipeline?
Lautet die letzte Antwort „ein neuer Prompt“, wuchert das Team.
Eine ehrliche Grenze
Nichts davon spricht gegen intensive Modellnutzung. Es spricht gegen Menge als Ziel. Eine Plattform kann helfen, indem sie Prüfung sichtbar macht, etwa welche Läufe warten, wie lange Reviews dauern und was die Prüfungen gefunden haben. Sie kann keine Aufmerksamkeit der Prüfenden erzeugen. Die muss wie jede knappe Ressource geplant und geschützt werden. Dieselbe Überlegung steckt im Argument zur Dark Factory: Den Menschen aus der Schleife zu nehmen ist eine Entscheidung mit Preis, kein Standard. Wo die Schleife und ihre Kontrollen sitzen, steht in Was ist ein Agent-Harness.
Das Wichtigste in Kürze
- AI Slop ist ungeprüfte Ausgabe in Menge; Prompt-Wildwuchs ist ein Weg dorthin.
- Prüfkapazität, nicht Erzeugungsgeschwindigkeit, ist der Engpass. Sie gehört ausdrücklich geplant.
- Die METR-Studie ist eine datierte Momentaufnahme (die Seite selbst nennt sie veraltet); die dauerhaftere Lehre ist DORAs Punkt, dass KI vorhandene Gewohnheiten eines Teams verstärkt.
- Weniger, kleinere, geprüfte Schritte und deterministische Prüfungen statt mehr Prompts und mehr Agenten.
- Prompts klein, verantwortet und versioniert halten; selten Gebrauchtes in Skills auslagern.
Quellen
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (2025-07-10; die Seite nennt die Ergebnisse inzwischen veraltet)
- Google Cloud, Announcing the 2025 DORA Report (2025-09-23)
- Anthropic, Effective context engineering for AI agents (2025-09-29)