Betriebsreihe: Runbooks zu Skills machen, ohne die Kontrolle zu verlieren
Runbook automation AI mit Kontrolle: Runbook in einen Skill plus eng begrenzte Tools mit Freigaben umwandeln. Eine Schritt-für-Schritt-Anleitung für Ops-Teams.
Dieser Beitrag ist auch auf English verfügbar.
Runbook-Automatisierung mit KI gelingt am besten, wenn Sie das Runbook in zwei Teile trennen: Das Wissen kommt in einen Skill, die Aktionen in wenige eng begrenzte Tools, mit Freigaben dort, wo es zählt. Ein Skill allein sagt dem Agenten nur, was zu tun ist. Die Tools bestimmen, was er tun kann. Wer beides trennt, gewinnt Tempo, ohne einem Agenten den Schlüssel zur Produktion zu überlassen.
Warum Runbooks gut passen
Betriebsteams tragen viel Ablaufwissen mit sich: was bei einem Plattenalarm zu tun ist, wie man ein Zertifikat erneuert, wie man einen Knoten leert. Vieles steht als Runbook geschrieben, und vieles davon ist langweilig. Das Google-SRE-Buch hat einen genauen Namen für Arbeit, die nicht manuell bleiben sollte:
Toil is the kind of work tied to running a production service that tends to be manual, repetitive, automatable, tactical, devoid of enduring value
Quelle: Site Reliability Engineering, Chapter 5: Eliminating Toil (Google, 2016). Sinngemäß: „Toil“ ist Arbeit rund um den Betrieb eines Produktionsdienstes, die meist manuell, repetitiv, automatisierbar und taktisch ist und keinen bleibenden Wert schafft.
Ein Runbook-Schritt, den ein Mensch rein mechanisch abarbeitet, ist ein Kandidat für Automatisierung. Ein Schritt, der Urteilsvermögen braucht, ist es nicht, jedenfalls nicht ohne Menschen in der Schleife. Die folgende Umstellung hilft, beides zu unterscheiden.
Was ein Skill ist und was nicht
Das Format Agent Skills beschreibt sich selbst so:
Agent Skills are a lightweight, open format for extending AI agent capabilities with specialized knowledge and workflows.
Quelle: Agent Skills overview. Sinngemäß: Agent Skills sind ein schlankes, offenes Format, um KI-Agenten um Spezialwissen und Abläufe zu erweitern.
Das passt gut zu einem Runbook: Spezialwissen und ein Ablauf. Ein Skill besteht überwiegend aus Markdown-Anweisungen, optional mit Skripten und Referenzdateien. Er hat keine eigene Befugnis. Steht im Skill „Pod neu starten“, der Agent hat aber kein Tool dafür, passiert nichts. Zur Dateistruktur siehe die Anatomie eines Agenten-Skills.
Deshalb lassen sich Skills auch günstig laden. Anthropic beschreibt das Entwurfsprinzip dahinter:
Progressive disclosure is the core design principle that makes Agent Skills flexible and scalable.
Quelle: Equipping agents for the real world with Agent Skills (Anthropic, 2025-10-16). Sinngemäß: Schrittweises Offenlegen ist das Kernprinzip, das Skills flexibel und skalierbar macht.
In der Praxis heißt das: Eine kurze Beschreibung ist immer sichtbar, das vollständige Runbook wird erst gelesen, wenn der Agent entscheidet, dass es passt.
Ein Runbook in Schritten umbauen
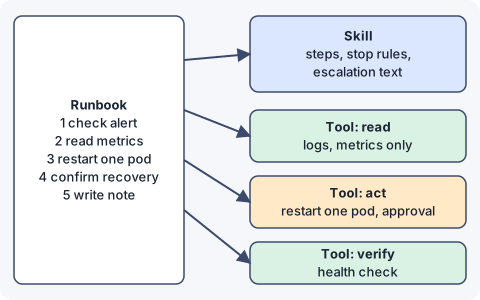
Nehmen Sie ein Runbook für einen ausfallenden Dienst und wandeln Sie es in fünf Schritten um.
- Jeden Schritt einordnen. Markieren Sie ihn als lesen (Logs, Metriken, Status ansehen), handeln (etwas ändern) oder prüfen (kontrollieren, ob die Änderung gewirkt hat). Die meisten Runbooks bestehen zu zwei Dritteln aus Lesen.
- Den Skill aus den Lese- und Entscheidungsschritten schreiben. Was zuerst zu prüfen ist, wie die Ausgabe zu deuten ist, wann man stoppt und eskaliert. Halten Sie Abbruchbedingungen ausdrücklich fest: „Sind mehr als ein Knoten betroffen, nicht fortfahren, eine Person alarmieren.“
- Jede Aktion als Tool statt als Prosa abbilden. Aus „per SSH auf den Host und systemctl restart“ wird ein Tool
restart_service(name), beschränkt auf eine benannte Liste von Diensten. Der Skill verweist per Namen darauf. - Jedes Tool so eng wie sinnvoll zuschneiden. Ein Dienst, eine Umgebung, begrenzte Argumente, eine Höchstzahl an Aufrufen pro Lauf. Lese-Tools erhalten reine Lese-Zugangsdaten, Handlungs-Tools eigene, getrennte.
- Ein Prüf-Tool ergänzen und im Skill aufrufen lassen. Der Lauf ist erst beendet, wenn die Prüfung besteht oder der Skill eskaliert.
Für ein Neustart-Runbook kann das so aussehen:
skill: restart-failing-service
tools:
  - name: read_service_status      # read: status, logs, metrics; read-only credentials
  - name: restart_service          # act: allowlisted services only
    approval: required
    maxCallsPerRun: 1
    args:
      service: { enum: [checkout, search, notifier] }
  - name: check_health             # verify: HTTP health endpoint, no side effects
Die genaue Syntax hängt von Ihrer Plattform ab; die Form ist entscheidend. Lesen ist frei, die einzige Handlung gibt ein Mensch frei, und ein Prüfschritt schließt die Schleife.
Freigaben: wo der Mensch dabei bleibt
Nicht jede Aktion braucht einen Menschen. Eine vernünftige Startregel:
| Art der Aktion | Beispiel | Freigabe |
|---|---|---|
| Lesen | Logs abrufen, Pods auflisten | keine |
| Umkehrbar, kleiner Wirkungsradius | einen zustandslosen Pod neu starten | automatisch nach einer Probephase |
| Umkehrbar, größere Wirkung | Deployment skalieren, Cache leeren | erforderlich |
| Nicht umkehrbar | Daten löschen, Schlüssel rotieren, DNS ändern | erforderlich, mit benannten Freigebenden |
Beginnen Sie mit Freigabe für jedes Handlungs-Tool. Wenn der Skill eine Weile korrekt gelaufen ist und der Audit-Trail es belegt, lockern Sie die Regeln für die risikoarmen Zeilen. Die letzte Zeile lockern Sie nie.
Skills wie auszurollenden Code behandeln
Ein Skill, der die Produktion steuern kann, ist Teil der Produktion. Daraus folgen zwei Regeln.
Erstens: versionieren und prüfen. Änderungen am Runbook-Text ändern, was der Agent tut, und brauchen dieselbe Prüfung wie eine Skriptänderung. Ein praktikables Schema steht in Skills versionieren.
Zweitens: nur vertrauen, was geprüft wurde. Anthropics Hinweis zu Skills ist bei Herkunftsfragen deutlich:
When installing a skill from a less-trusted source, thoroughly audit it before use.
Quelle: Equipping agents for the real world with Agent Skills. Sinngemäß: Wer einen Skill aus weniger vertrauenswürdiger Quelle installiert, soll ihn vorher gründlich prüfen.
Ein aus dem Internet kopierter Skill kann Anweisungen oder Skripte enthalten, die Sie nie mit Produktionszugangsdaten ausführen wollten. Lesen Sie ihn, pinnen Sie ihn und geben Sie ihm nur die Tools, die er braucht.
Testen, bevor man vertraut
Lassen Sie den umgebauten Skill auf drei Arten laufen, bevor er einem echten Vorfall nahekommt:
- Replay. Mit Logs und Metriken eines früheren Vorfalls füttern und die Diagnose mit dem Ergebnis des Teams vergleichen.
- Trockenlauf. Handlungs-Tools geben, die nur protokollieren, was sie tun würden.
- Game Day. In der Staging-Umgebung einen harmlosen Fehler auslösen und den Agenten damit umgehen lassen, während eine Ingenieurin oder ein Ingenieur zusieht.
Geht in einem echten Lauf etwas schief, gilt dieselbe Disziplin wie bei jeder automatisierten Änderung: stoppen, Spuren sichern, auswerten. Diese Seite behandelt Incident Response für Agenten.
Was das nicht löst
Ehrlich gesagt: Ein Skill ersetzt kein fehlendes Tool, und ein Tool ersetzt kein vages Runbook. Steht im Runbook „untersuchen und beheben“, zeigt die Umstellung, dass niemand aufgeschrieben hat, was Untersuchen bedeutet. Rechnen Sie damit, dass die erste Umstellung das Runbook selbst verbessert. Rechnen Sie auch damit, dass manche Schritte manuell bleiben; das ist in Ordnung, denn das Ziel ist weniger Toil, nicht null Menschen.
Das Wichtigste in Kürze
- Ein Runbook in einen Skill (Wissen, Entscheidungen, Abbruchregeln) und Tools (Aktionen) aufteilen.
- Schritte als lesen, handeln oder prüfen einordnen; die meisten sind Lesen.
- Jedes Tool eng zuschneiden und Freigaben auf alles legen, was Zustand ändert, zumindest anfangs.
- Skills wie auszurollenden Code versionieren und prüfen; alles aus weniger vertrauenswürdiger Quelle auditieren.
- Mit Replays, Trockenläufen und Game Days testen, bevor ein echter Vorfall eintritt.
Quellen
- Site Reliability Engineering, Chapter 5: Eliminating Toil, Google, 2016.
- Agent Skills overview, agentskills.io.
- Equipping agents for the real world with Agent Skills, Anthropic, 2025-10-16.