Betriebsreihe: AI Incident Response, wenn ein Agent der Akteur ist
AI Incident Response behält die Phasen, braucht aber Kill Switch, Tool-Entzug und Policy-Freeze in Sekunden. Playbook und Postmortem für Agenten-Vorfälle.
Dieser Beitrag ist auch auf English verfügbar.
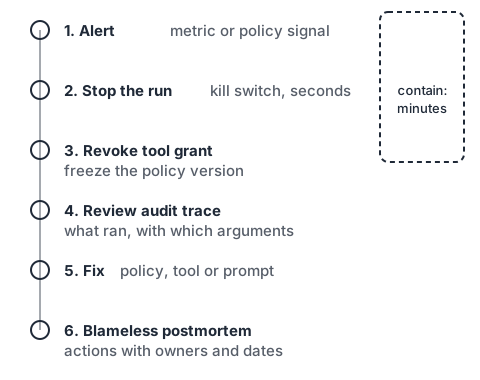
AI Incident Response folgt denselben Phasen wie jede andere Vorfallsbehandlung: vorbereiten, erkennen, eindämmen, wiederherstellen, lernen. Anders sind das Tempo und die Form der Eindämmung. Ein Agent kann Hunderte von Werkzeugaufrufen ausführen, während ein Mensch noch den Alarm liest. Sie brauchen deshalb Mittel, die einen Lauf stoppen, ein Werkzeug entziehen und eine Policy einfrieren, und zwar in Sekunden, nicht erst nach der Ticket-Triage. Dieser Beitrag überträgt ein gängiges Incident-Playbook und das Blameless Postmortem auf Vorfälle, bei denen ein Agent der Akteur ist.
Warum Agenten-Vorfälle anders sind
Ein klassischer Vorfall hat meist einen begrenzten Akteur: einen geleakten Schlüssel, den ein Skript nutzt, ein fehlerhaftes Deployment, einen falsch konfigurierten Bucket. Bei Agenten kommen drei Eigenschaften hinzu, die die Arbeit erschweren.
- Der Akteur entscheidet zur Laufzeit. Welche Werkzeuge mit welchen Argumenten aufgerufen werden, hängt von der Modellausgabe ab, und die hängt von jedem Text im Kontext ab. Aus dem Code lässt sich der nächste Schritt nicht ablesen.
- Der Akteur ist schnell und parallel. Mehrere Läufe können gleichzeitig laufen und reale Systeme verändern.
- Die Ursache kann Text sein. Eine Prompt-Injection in einem Ticket, eine vergiftete Werkzeugbeschreibung oder ein irreführendes Dokument kann einen Lauf lenken, ohne dass Code oder Konfiguration geändert wurden.
Die Disziplin ist damit nicht neu. Die überarbeitete NIST-Richtlinie ordnet die Vorfallsbehandlung in das gesamte Risikomanagement ein und sagt, dass sich die Vorbereitung auszahlt (Zitat im englischen Original; sinngemäß: Vorbereitung hilft, die Zahl und die Auswirkungen von Vorfällen zu senken):
Doing so can help organizations prepare for incident responses, reduce the number and impact of incidents that occur
Quelle: NIST SP 800-61 Rev. 3. Der Satz gilt für Organisationen allgemein und passt unverändert auf eine Agentenplattform: Was Sie um 3 Uhr nachts brauchen, muss vor 3 Uhr nachts existieren.
Auch die Bedrohungsseite ist nicht theoretisch. Anthropic hat eine Kampagne beschrieben, in der Angreifer einen Agenten den Großteil der Arbeit machen ließen (englisches Originalzitat):
the threat actor was able to use AI to perform 80-90% of the campaign
Quelle: Anthropic, Disrupting an AI-orchestrated cyber espionage campaign. Ob der nächste Vorfall von einem Angreifer mit Agenten kommt oder vom eigenen Agenten, der aus dem Ruder läuft: Die Reaktion muss von einem schnellen, automatisierten Akteur ausgehen.
Vorbereiten: Mittel, die vorher existieren müssen
Vor dem ersten Vorfall sollte Folgendes vorhanden und einmal in einer Übung erprobt sein.
- Ein Kill Switch auf Laufebene. Eine Aktion, die einen Lauf stoppt und ausstehende Werkzeugaufrufe abbricht, für die Bereitschaft verfügbar, ohne dass ein Deployment nötig ist.
- Entzug von Werkzeugen. Die Möglichkeit, einem Agenten oder allen Agenten sofort ein einzelnes Werkzeug zu entziehen. Ein Werkzeug zu sperren ist deutlich weniger störend, als die Plattform abzuschalten.
- Policy-Freeze. Ein Weg, auf eine bekannte, strengere Policy-Version umzuschalten (etwa nur lesend), während Sie untersuchen.
- Vollständige Traces. Jeder Werkzeugaufruf mit Argumenten, der Entscheidung, die ihn erlaubt oder abgelehnt hat, und der Identität, unter der er lief. Was aufzuzeichnen ist, steht in Observability für Agenten; warum der Audit-Eintrag manipulationssicher sein sollte, in Policy entscheidet, Audit beweist.
- Zuständigkeit. Jeder Agent hat ein benanntes Team und einen Eskalationsweg, wie jeder andere Dienst. Genau darum geht es in Agent-Betrieb ist einfach Betrieb.
Erkennen: sinnvolle Alarmsignale
Alarme sollten auf Verhalten auslösen, nicht nur auf Fehler.
- Ein Lauf überschreitet sein Token- oder Kostenbudget.
- Ein Anstieg abgelehnter Werkzeugaufrufe (ein Agent testet wiederholt die Grenze seiner Policy).
- Ein Werkzeug wird mit Argumenten weit außerhalb des Üblichen oder zu einer unerwarteten Zeit aufgerufen.
- Ausgehender Verkehr zu einem Host, der nicht auf der Erlaubnisliste steht.
- Ein Lauf, der deutlich mehr Datensätze berührt als vergleichbare Läufe.
Jeder Alarm braucht im Text einen Link zum Runbook. Ein Alarm, der nachts nur „Anomalie“ meldet, ist ein schlechter Alarm.
Eindämmen: erst stoppen, dann verstehen
Hier unterscheidet sich der Agentenfall am stärksten. Halten Sie die Reihenfolge kurz genug für eine Bildschirmseite.
1. Lauf/Läufe stoppen        Kill Switch, ausstehende Aufrufe abbrechen
2. Werkzeug entziehen        engster Entzug, der den Schaden stoppt
3. Policy einfrieren         strenge Version festnageln, Deployments sperren
4. Beweise sichern           Traces und Audit-Einträge des Zeitraums exportieren
5. Informieren               Verantwortliche, Security, betroffene Systemeigner
Zwei Details sind wichtig. Erstens: erst entziehen, dann untersuchen. Einen Trace mit 400 Schritten zu lesen dauert, und der Agent sollte in der Zeit nicht weiterlaufen. Zweitens: erst sichern, dann aufräumen. Löscht die Reaktion die Artefakte des Laufs, fehlen dem Postmortem die Belege.
Waren Zugangsdaten betroffen, rotieren Sie sie als Teil der Eindämmung und prüfen, ob der Agent überhaupt je ein langlebiges Geheimnis hielt. Besser sind kurzlebige, eng begrenzte Zugangsdaten, damit die Rotation günstig ist.
Wiederherstellen: die Ursache beheben, nicht nur das Symptom
Die Wiederherstellung hat drei Schichten, und viele Teams hören bei der ersten auf.
- Wirkungen rückgängig machen. Die Änderungen des Agenten zurücknehmen. Das ist viel einfacher, wenn Aktionen idempotent sind und genug Details protokolliert werden, um sie umzukehren.
- Den Pfad schließen. Das Werkzeug entfernen, die Argumentbeschränkung verschärfen, eine Freigabe für die riskante Aktion ergänzen oder die fehlende Egress-Regel nachziehen.
- Erneut testen. Den Vorfall als Regressionsfall in die Evaluierungen aufnehmen, damit dasselbe Eingabemuster bei jeder künftigen Änderung geprüft wird.
Nehmen Sie den Agenten stufenweise wieder in Betrieb: zuerst nur lesend, dann mit den engen Werkzeugen, dann mit dem vollen Satz. Beobachten Sie dabei dieselben Signale, die den Vorfall entdeckt haben.
Lernen: ein Blameless Postmortem für Agenten
Blameless Postmortems lassen sich direkt übernehmen. Das SRE-Buch von Google sagt es klar (englisches Originalzitat; sinngemäß: Schuldzuweisungsfreie Postmortems sind ein Grundsatz der SRE-Kultur):
Blameless postmortems are a tenet of SRE culture.
Quelle: Google SRE-Buch, Kapitel 15, Postmortem Culture. Bei Agenten-Vorfällen hat „schuldzuweisungsfrei“ eine zusätzliche Bedeutung: Geben Sie nicht dem Modell die Schuld. Ein Modell, das einer eingeschleusten Anweisung folgt, hat getan, was Modelle tun. Die Frage ist, warum die Plattform daraus eine schädliche Aktion werden ließ.
Eine Postmortem-Vorlage, die sich bewährt:
Zusammenfassung   ein Absatz, einfache Sprache
Auswirkung        was sich geändert hat, wer betroffen war, wie lange
Zeitleiste        Alarm, Stopp, Entzug, Fix (mit Zeitstempeln)
Trace             die entscheidenden Aufrufe und der Kontext davor
Grundursachen     fehlende Kontrolle, falsche Policy, schlechtes Tool-Design (nicht "das Modell")
Was gut lief      Kontrollen, die gewirkt haben (Kill Switch, Budgetgrenze)
Maßnahmen         Verantwortliche, Termin, Prüfverfahren
Besprechen Sie die Maßnahmen im nächsten Betriebstermin, statt sie in einem Dokument altern zu lassen.
Eine kurze Übung für diese Woche
Wählen Sie einen Testagenten in einer Nicht-Produktionsumgebung und geben Sie ihm eine Aufgabe. Dann:
- Starten Sie die Uhr, wenn Sie einen Alarm auslösen.
- Stoppen Sie den Lauf mit dem echten Kill Switch.
- Entziehen Sie ein Werkzeug und prüfen Sie, dass der nächste Aufruf abgelehnt wird.
- Holen Sie den Trace und beantworten Sie: Welcher Aufruf war der letzte, der nicht hätte passieren dürfen?
- Schreiben Sie drei Maßnahmen auf.
Hat ein Schritt mehr als wenige Minuten gedauert oder jemanden mit Sonderrechten gebraucht, der nicht in Bereitschaft war, ist das Ihre erste Maßnahme.
Wichtigste Punkte
- Die Incident Response für Agenten nutzt die üblichen Phasen, aber die Eindämmung muss in Sekunden funktionieren.
- Bauen Sie Kill Switch, Werkzeugentzug und Policy-Freeze, bevor Sie sie brauchen, und üben Sie sie.
- Erst entziehen, dann untersuchen, und Beweise sichern, bevor aufgeräumt wird.
- Postmortems bleiben schuldzuweisungsfrei: Fragen Sie, warum die Plattform die Aktion zuließ, nicht warum das Modell sie erzeugte.
- Machen Sie jeden Vorfall zu einem Regressionstest Ihrer Evaluierungen.
Quellen
- NIST, SP 800-61 Rev. 3, Incident Response Recommendations and Considerations for Cybersecurity Risk Management (2025).
- Google, Site Reliability Engineering, Chapter 15: Postmortem Culture (Buch 2016, Online-Ausgabe).
- Anthropic, Disrupting an AI-orchestrated cyber espionage campaign (2025).