Fremde Skills sind Lieferkette: eine Prüfliste für Agent-Skill-Sicherheit
Agent-Skill-Sicherheit beginnt damit, fremde Skills als Abhängigkeiten zu behandeln. Prüfliste zu Herkunft, Versionsfixierung, Review und Rechten.
Dieser Beitrag ist auch auf English verfügbar.
Agent-Skill-Sicherheit beginnt mit einer Umdeutung: Einen fremden Skill zu installieren heißt, eine Abhängigkeit hinzuzufügen. Ein Skill ist ein Ordner mit Anweisungen und oft Skripten, die mit den Rechten des Agenten laufen. Ein bösartiger oder nachlässiger Skill kann in Ihrem Namen Daten lesen, Tools aufrufen und Code ausführen. Prüfen Sie ihn wie eine Bibliothek, die auf Ihrem Build-Server läuft, und gründlicher, denn ein Teil ist in natürlicher Sprache geschrieben und an Ihren Agenten gerichtet.
Warum Skills sich von Dokumenten unterscheiden
Ein Skill sieht aus wie Dokumentation: eine Markdown-Datei mit Namen und Beschreibung, dazu vielleicht Referenzdateien und Skripte. Sein Aufbau macht ihn mächtig. Das Entwicklerteam von Anthropic beschreibt den Mechanismus (Zitate im englischen Original):
Progressive disclosure is the core design principle that makes Agent Skills flexible and scalable.
Equipping agents for the real world with Agent Skills (Anthropic, 2025)
Sinngemäß: Schrittweises Offenlegen ist das Kernprinzip, das Agent Skills flexibel und skalierbar macht. Nur eine kurze Beschreibung steht dauerhaft im Kontext; die vollständigen Anweisungen und Dateien werden geladen, wenn der Agent den Skill für relevant hält. Für die Sicherheit hat das zwei Folgen. Erstens sieht, wer nur die Beschreibung liest, einen Bruchteil dessen, was der Agent später liest. Zweitens kommt der bei Bedarf geladene Inhalt als vertrauenswürdig wirkende Anweisung an, und das ist die Einfallstür für die Angriffe aus Indirekte Prompt-Injection. Zum Aufbau eines wohlgeformten Skills siehe Aufbau eines Agent-Skills.
Derselbe Artikel ist deutlich, was mit Skills aus weniger vertrauenswürdigen Quellen zu tun ist:
When installing a skill from a less-trusted source, thoroughly audit it before use.
Equipping agents for the real world with Agent Skills (Anthropic, 2025)
Sinngemäß: Bei Skills aus weniger vertrauenswürdigen Quellen vor der Nutzung gründlich prüfen. Der Rest dieses Beitrags macht aus „gründlich prüfen“ eine konkrete Prüfliste.
Was schiefgehen kann
- Versteckte Anweisungen. Text im Skill, in einer referenzierten Datei oder in einem HTML-Kommentar bringt den Agenten dazu, Regeln zu ignorieren, Daten woandershin zu senden oder seine Aktionen zu verbergen.
- Bösartige Skripte. Ein mitgeliefertes Skript lädt Code nach und führt ihn aus, liest Umgebungsvariablen oder schreibt in Dateien mit Zugangsdaten.
- Abrufe zur Laufzeit. Der Skill weist den Agenten an, Anweisungen beim Lauf von einer URL zu lesen. Der Besitzer der URL kann den Inhalt nach Ihrer Prüfung ändern.
- Tool-Poisoning. Beschreibungen von Tools, auf die sich ein Skill stützt, tragen versteckte Anweisungen. Invariant Labs beschrieb das für MCP-Tools als
a specialized form of indirect prompt injections
MCP Security Notification: Tool Poisoning Attacks (Invariant Labs, 2025)
Sinngemäß: eine spezialisierte Form indirekter Prompt-Injection.
- Stille Updates. Das Upstream-Repository ändert sich nach der Installation, und Ihr Agent folgt dem neuen Text.
- Zu weite Berechtigungen. Der Skill verlangt oder setzt Tools voraus, die er nicht braucht.
Die Prüfliste
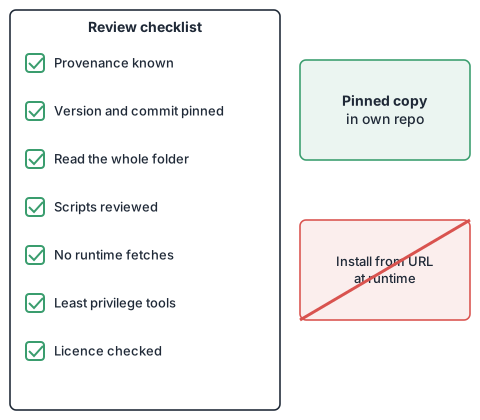
1. Herkunft
Wer hat ihn geschrieben, wo liegt er, und lässt sich das überprüfen? Bevorzugen Sie Autoren und Repositories mit sichtbarer Historie, signierten Tags oder Releases und einer Lizenz. Ein anonymes Snippet aus einem Forum ist keine Quelle. Halten Sie die Herkunft (URL, Commit, Datum) in einer Datei neben der Kopie fest.
2. Version fixieren
Folgen Sie nie „latest“. Wählen Sie einen exakten Commit oder Release und behalten Sie eine Kopie dieser Version. Ein Skill, der sich upstream ändert, braucht eine neue Prüfung, wie ein Abhängigkeits-Update. Das ist die Disziplin aus Change-Management für Agenten, angewandt auf eingehende Artefakte.
3. Den ganzen Ordner lesen
Lesen Sie jede Datei, nicht nur die Hauptanweisung: Referenzen, Vorlagen, Skripte, versteckte Dateien, Binärblöcke. Suchen Sie nach den üblichen Verdächtigen:
grep -rniE "curl|wget|http[s]?://|eval|base64|exec|subprocess|\.env|ssh|token|password" skill-folder/
grep -rniE "ignore (all|previous)|do not tell|secretly|without asking" skill-folder/
Eine Suche ist ein Hilfsmittel, kein Urteil. Lesen Sie die Treffer und lesen Sie, was die Suche nicht findet, etwa ungewöhnlich kodierten Text. Ist eine Datei ein Binär- oder minifizierter Block, den Sie nicht lesen können, installieren Sie nicht.
4. Keine Abrufe zur Laufzeit
Der Skill darf den Agenten nicht anweisen, beim Lauf Anweisungen, Skripte oder Pakete herunterzuladen. Braucht er eine Abhängigkeit, legen Sie sie in die fixierte Kopie oder installieren Sie sie aus einem geprüften Lockfile. Die Regel „nie Anweisungen zur Laufzeit aus dem Internet laden“ ist einfach zu formulieren und mit dem obigen grep einfach zu prüfen.
5. Skripte wie Code prüfen
Für jedes Skript: Was liest, schreibt, führt es aus und sendet es ins Netz? Lassen Sie es zuerst in einer Sandbox ohne Zugangsdaten laufen. Prüfen Sie, dass es nicht aus dem eigenen Arbeitsverzeichnis des Skills hinausgreift.
6. Minimale Rechte
Geben Sie dem Agenten, der den Skill nutzt, nur die Tools, die der Skill braucht, und beschränken Sie deren Argumente. Ein Formatierungs-Skill braucht weder Netzwerk noch Schreibzugriff außerhalb des Projekts. Wie sich Tools pro Agent eingrenzen lassen, steht in Minimale Rechte für Agenten.
7. Eine fixierte Kopie im eigenen Repository halten
Installieren Sie aus der eigenen, geprüften Kopie, nicht von einer URL. Das gibt Ihnen einen Diff für jedes Update, einen Ort für den Prüfvermerk und Unabhängigkeit von Upstream-Änderungen oder Löschungen.
Integrität prüfen, wo es geht
OWASPs Hinweise zu Lieferkettenrisiken bei LLMs sind für Modelle geschrieben, das Prinzip gilt aber für jedes Artefakt, das Sie hereinholen:
Only use models from verifiable sources and use third-party model integrity checks with signing and file hashes
LLM03:2025 Supply Chain (OWASP Gen AI Security Project)
Sinngemäß: Nur Modelle aus überprüfbaren Quellen verwenden und Integritätsprüfungen mit Signaturen und Datei-Hashes einsetzen. Bei Skills entsprechen dem signierte Tags oder Releases, wo der Autor sie anbietet, und ein im Repository festgehaltener Hash Ihrer geprüften Kopie, damit eine geänderte Datei auffällt.
Nach der Installation
Die Prüfung endet nicht mit der Installation. Protokollieren Sie, welche Skills in jedem Lauf geladen wurden, damit sich ein Vorfall einer Skill-Version zuordnen lässt. Achten Sie nach einem Update auf Verhaltensänderungen. Führen Sie ein Inventar der installierten Skills mit Verantwortlichem, Version, Quelle und Prüfdatum und entfernen Sie, was niemand nutzt. Begrenzen Sie standardmäßig, was ein kompromittierter Skill tun könnte, mit Policy-Gates, die nicht von der Mitwirkung des Modells abhängen.
Grenzen
Keine Checkliste macht einen unbekannten Skill sicher, denn natürlichsprachliche Anweisungen lassen sich so tarnen, dass kein Scanner sie verlässlich findet. Die ehrliche Position lautet: Prüfung senkt das Risiko, minimale Rechte begrenzen den Schaden, und was sich nicht prüfen lässt, wird nicht installiert.
Das Wichtigste in Kürze
- Ein fremder Skill ist eine Abhängigkeit, die Anweisungen und ausführbaren Code tragen kann.
- Klären Sie die Herkunft, fixieren Sie eine exakte Version und lesen Sie den ganzen Ordner, nicht nur die Hauptdatei.
- Verbieten Sie Abrufe zur Laufzeit; legen Sie ab oder sperren Sie per Lockfile, was der Skill braucht.
- Prüfen Sie Skripte wie Code und führen Sie sie zuerst in einer Sandbox ohne Zugangsdaten aus.
- Installieren Sie aus einer fixierten Kopie im eigenen Repository und geben Sie dem Agenten nur die nötigen Tools.
Quellen
- Equipping agents for the real world with Agent Skills, Anthropic, 16.10.2025.
- LLM03:2025 Supply Chain, OWASP Gen AI Security Project.
- MCP Security Notification: Tool Poisoning Attacks, Invariant Labs, 01.04.2025.