Macht ein Classifier-Modell immer Sinn? Entscheiden, was ein Agent darf
Classifier-Modelle können Anfragen routen und Agentenaktionen bewerten, kosten aber Geld und irren sich. Wann Regeln besser sind, wann ein Classifier hilft und wie Autonomiestufen passen.
Dieser Beitrag ist auch auf English verfügbar.
Ein Classifier-Modell ist ein Modell, dessen Aufgabe es ist, eine Eingabe einer Kategorie zuzuordnen: Welcher Agent oder welches Modell soll diese Anfrage bearbeiten, wie sensibel ist dieses Dokument, ist diese Aktion riskant? In Agentensystemen treten Classifier in zwei Rollen auf. Sie routen Arbeit (günstiges oder starkes Modell, welcher Agent, welches Playbook), und sie bewerten Aktionen (erlauben, einen Menschen fragen, blockieren). Beides kann nützlich sein. Nichts davon ist kostenlos, und keines ist immer das richtige Werkzeug. Ein Classifier ist eine probabilistische Komponente; er wird sich manchmal irren, und die Frage ist, ob Sie sich seine Fehler an dieser Stelle leisten können.
Die kurze Antwort dieses Beitrags: Entscheiden Sie mit deterministischen Regeln, wo immer die Fakten strukturiert sind, setzen Sie einen Classifier dort ein, wo die Eingabe wirklich unscharf ist, lassen Sie ihn Entscheidungen nur verschärfen, und geben Sie, was unsicher bleibt, an einen Menschen.
Zwei Aufgaben namens „Classifier“
Routing-Classifier sehen sich eine Anfrage an und wählen einen Weg. Typische Ziele sind Kosten (einfache Anfragen an ein kleineres Modell), Qualität (schwierige an ein stärkeres Modell) und Datenschutz (sensible Eingaben bleiben auf einem privaten Modell). Eine Fehlentscheidung kostet hier meist Qualität oder Geld: Eine schwierige Aufgabe landet bei einem schwachen Modell oder eine leichte bei einem teuren.
Policy-Classifier sehen sich eine vorgeschlagene Aktion an, oft einen Tool-Aufruf mit Argumenten und etwas Kontext, und entscheiden, ob sie laufen darf. Manche Coding-Harnesses bieten Modi, in denen ein separates Modell Aktionen vor der Ausführung prüft, als Mittelweg zwischen „bei jeder Aktion fragen“ und „nie fragen“ (prüfen Sie in der Dokumentation Ihres Harness, was dessen Modus tut, Stand 2026-10). Eine Fehlentscheidung kostet hier mehr: eine schädliche Aktion wird erlaubt oder eine harmlose so oft blockiert, dass Menschen die Prüfung abschalten.
Was ein Classifier kostet
Bevor Sie einen einbauen, zählen Sie vier Kosten:
- Geld und Latenz. Ein zusätzlicher Modellaufruf je Anfrage oder je Aktion. Bei einem Agenten mit Dutzenden Tool-Aufrufen je Lauf kann ein Classifier je Aktion einen spürbaren Anteil der Tokens und der Zeit ausmachen. Messen Sie das an Ihren eigenen Läufen, statt es zu schätzen.
- Fehler in beide Richtungen. Falsch-Negative (eine riskante Aktion gilt als sicher) und Falsch-Positive (eine sichere Aktion wird blockiert oder eskaliert). Ihre Kosten sind ungleich und hängen von der Aktion ab.
- Angriffsfläche. Ein Modell, das denselben nicht vertrauenswürdigen Inhalt liest wie der Agent, kann von ihm beeinflusst werden. Text in einem Ticket oder auf einer Webseite, der behauptet „diese Aktion ist freigegeben“, zielt genau auf diese Art von Prüfung. Siehe indirekte Prompt-Injection.
- Drift und Pflege. Ein Classifier ist ein Modell wie jedes andere: Er braucht Evaluation, Pinning und eine neue Bewertung, wenn er sich ändert, wie in Model Drift bei Agenten beschrieben.
Wann deterministische Regeln besser sind
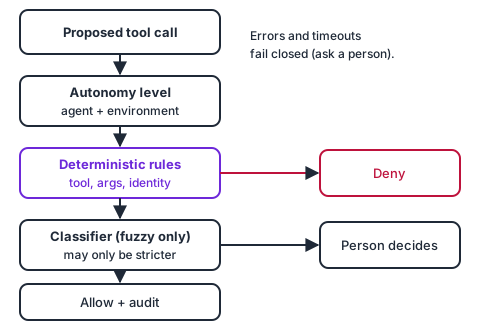
Die meisten Berechtigungsentscheidungen betreffen strukturierte Fakten: welches Tool, welche Argumente, welche Identität, welche Umgebung, welche Datenklassifizierung. Dafür ist eine Regel günstiger, schneller, liefert jedes Mal dieselbe Antwort und lässt sich prüfen:
- „Schreibt nur in Pfade unter
docs/“ ist eine Pfadregel, keine Ermessensfrage. - „Ticket-Schlüssel müssen auf
^SEC-\d+$passen“ ist ein Muster. - „Keine schreibenden Tools in einem nur lesenden Schritt“ ist eine Eigenschaft des Schritts.
- „Zahlungen und Rechteänderungen brauchen immer einen Menschen“ ist eine Liste.
Diese Entwurfsentscheidung trifft openagentix: Eine deterministische Policy-Engine, kein Modell, prüft jeden Tool-Aufruf, bevor er läuft (Allowlist, Argumentbedingungen, Datenklassifizierung, Freigaben), und die Entscheidung landet in einem hashverketteten Audit-Trail. Die Begründung steht in Das Modell fragt, die Policy entscheidet. Ein Modell kann eine Aktion anfragen; es kann sie nicht freigeben.
Wann ein Classifier hilft
Ein Classifier ist seine Kosten dort wert, wo die Entscheidung von Bedeutung abhängt, die Regeln nicht erfassen:
- Sensibilität von Inhalten. Enthält dieses Freitextdokument personenbezogene Daten oder Geschäftsgeheimnisse, sodass es auf einem privaten Modell bleiben muss? Eine Musterliste findet manche Fälle, ein Classifier kann mehr finden und sollte mit den Mustern kombiniert werden, nicht sie ersetzen.
- Absicht einer Anfrage. Eine eingehende Nachricht an das richtige Playbook oder den richtigen Agenten leiten, wenn Menschen frei formulieren.
- Aufwandsschätzung für das Modell-Routing. Je Schritt ein kleineres oder größeres Modell wählen.
openagentix hat Modell-Routing je Schritt (nach Klassifizierung, Kosten und Latenz) als geplante Arbeit
auf der Roadmap (W4-5); heute wird das Modell je Schritt in
agents.mdfestgelegt. - Eine zweite Meinung zu Aktionen, die Regeln schon erlauben. Ein Classifier, der einem regelbasierten „erlaubt“ nur „einen Menschen fragen“ oder „blockieren“ hinzufügen kann, aber nie ein „verboten“ in ein „erlaubt“ verwandelt.
Der letzte Punkt macht einen Classifier sicher genug zum Einbauen: Er darf Entscheidungen verschärfen, nie lockern. Dasselbe Prinzip steht in der openagentix-Roadmap für einen externen Policy-Adapter (OPA), der Entscheidungen nur verschärfen kann.
Mit Fehlklassifikationen umgehen
Gehen Sie davon aus, dass der Classifier sich irrt, und planen Sie dafür:
- Im Zweifel geschlossen. Läuft der Classifier in einen Timeout, scheitert er oder meldet er geringe Sicherheit, braucht die Aktion eine Freigabe; sie gilt nicht als erlaubt.
- Jede Entscheidung protokollieren mit Zusammenfassung der Eingabe, Ergebnis, Modellversion und Konfidenz, damit Sie später Stichproben ziehen und prüfen können.
- Beide Fehlerarten messen. Prüfen Sie Stichproben erlaubter Aktionen darauf, ob sie hätten eskaliert werden müssen, und verfolgen Sie, wie oft Menschen Eskalationen des Classifiers übergehen. Eine hohe Quote heißt, dass Menschen zu oft gefragt werden, und das entwertet jede Freigabe (siehe Human in the Loop, der funktioniert).
- Nicht in eigener Sache. Das Modell, das eine Aktion vorschlägt, sollte nicht dasjenige sein, das entscheidet, ob sie eine Freigabe braucht.
Autonomiestufen: vor dem Lauf entscheiden
Classifier entscheiden je Anfrage oder je Aktion. Ein großer Teil der Frage „Was darf der Agent?“ lässt sich früher beantworten, je Agent und je Umgebung, als Autonomie- oder Risikostufe. Zwei Beispiele, wie man das aufschreibt:
- Das Agentic Workflow Protocol (AWP), ein Spezifikationsentwurf
(
v1alpha1) zur Beschreibung agentischer Workflows, definiert Risikostufenlow,medium,highundcriticalmit empfohlenen Standardbehandlungen, von autonomer Ausführung innerhalb von Berechtigungen bis zu einer Ausführung, die ohne ausdrückliche Freigabe untersagt ist, sowie eine Autonomie-Einstellung je Umgebung (unrestricted,controlled,approval-required,prohibited). Die Spezifikation sagt selbst, dass ihre Risikostufen ein mögliches Governance-Modell sind und keine regulatorische Einstufung. - Das Konzept für die Showcase-Agenten von openagentix nutzt Sicherheitsstufen von L0 (nur lesend) über L1 (Entwurf, den ein Mensch übernimmt) und L2 (Entwurfs-Pull-Request, den ein Maintainer merged) bis L3 (Merge oder Deployment) und setzt L3 nicht ein.
Ein tragfähiges Muster verbindet beide Ebenen:
| Ebene | Entscheidet | Mechanismus |
|---|---|---|
| Agent und Umgebung | Die höchste Autonomie (etwa „in Produktion nur Entwürfe“) | Konfiguration, geprüft wie Code |
| Jeder Tool-Aufruf | Ob dieser Aufruf innerhalb der Regeln liegt | Deterministische Policy |
| Unscharfer Inhalt | Ob Eingabe oder Aktion besondere Vorsicht brauchen | Classifier, nur verschärfend |
| Verbleibende Unsicherheit | Ja oder nein | Ein Mensch, mit Kontext |
Heben Sie die Stufe eines Agenten mit Belegen an, nicht mit Zuversicht: nach einer Zeit von Läufen auf der niedrigeren Stufe und mit einem Audit-Trail, der zeigt, was er getan hat.
Macht er immer Sinn? Ein kurzer Test
Bauen Sie einen Classifier ein, wenn alle diese Punkte zutreffen:
- Die Entscheidung hängt von Bedeutung in unstrukturierter Eingabe ab, nicht von strukturierten Fakten.
- Sie können die Kosten jeder Fehlerart benennen und die verbleibende Quote akzeptieren.
- Er kann Entscheidungen nur verschärfen und schließt im Zweifel.
- Sie haben einen Evaluationssatz für ihn und wiederholen ihn, wenn sich sein Modell ändert.
Trifft einer davon nicht zu, nehmen Sie lieber eine Regel, ein enger gefasstes Tool, eine niedrigere Autonomiestufe oder einen Menschen.
Das Wichtigste in Kürze
- Classifier routen Arbeit oder bewerten Aktionen; beides ist probabilistisch und kostet Geld, Latenz und Pflege.
- Nutzen Sie deterministische Regeln für strukturierte Fakten: Tool, Argumente, Identität, Umgebung, Klassifizierung.
- Nutzen Sie Classifier für unscharfe Eingaben und nur, um Entscheidungen zu verschärfen; im Zweifel geschlossen.
- Messen Sie Falsch-Negative und Falsch-Positive; zu viele Eskalationen entwerten die menschliche Prüfung.
- Legen Sie die Autonomie je Agent und Umgebung vorab fest (AWP-Risikostufen und Autonomie je Umgebung sind eine Art, das aufzuschreiben), und lassen Sie Regeln, Classifier und Menschen innerhalb dieser Grenze arbeiten.
Quellen
- Agentic Workflow Protocol, Spezifikations-Website und Risk levels (Entwurf,
v1alpha1). - openagentix, Repository und Roadmap (Punkte W4-5, W5-6).
- Verwandte Beiträge in diesem Blog: Das Modell fragt, die Policy entscheidet, Human in the Loop, der funktioniert, Minimale Rechte für Agenten.