Human in the Loop bei KI-Agenten, der funktioniert: weniger Freigaben, bessere
Human in the Loop bei KI-Agenten scheitert, wenn jeder Aufruf bestätigt werden muss. Menschen für riskante Aktionen, mit Kontext; den Rest regelt Policy.
Dieser Beitrag ist auch auf English verfügbar.
Human in the Loop bei KI-Agenten funktioniert, wenn Freigaben selten, konkret und informiert sind, und er scheitert, wenn eine Person jeden Werkzeugaufruf bestätigen soll. Das erste Design behält die Kontrolle über die Aktionen, auf die es ankommt. Das zweite trainiert Menschen darauf, ohne Lesen auf „Genehmigen“ zu klicken, und das ist schlechter als gar keine Rückfrage, weil es wie eine Kontrolle aussieht, ohne eine zu sein. Dieser Beitrag plädiert für eine andere Aufteilung: deterministische Policy fürs Routinemäßige, eine menschliche Entscheidung für das Riskante und genug Kontext im Moment der Entscheidung, damit sie echt ist.
Was die Standards tatsächlich verlangen
Die Spezifikation des Model Context Protocol wird oft so zitiert, als verlange sie, dass eine Person jeden Werkzeugaufruf bestätigt. Lesen Sie genau: Der Satz handelt von der Möglichkeit abzulehnen (englisches Originalzitat; sinngemäß: Es sollte immer einen Menschen geben, der Werkzeugaufrufe ablehnen kann):
there SHOULD always be a human in the loop with the ability to deny tool invocations.
Quelle: MCP-Spezifikation 2025-06-18, Tools. Das ist eine Empfehlung, die Kontrolle verfügbar zu halten, keine Forderung, jeden Aufruf zu bestätigen. Dieselbe Seite ist auch offen darüber, woher Werkzeug-Metadaten kommen (englisches Originalzitat; sinngemäß: Clients müssen Annotationen als nicht vertrauenswürdig behandeln, sofern sie nicht von vertrauenswürdigen Servern stammen):
clients MUST consider tool annotations to be untrusted unless they come from trusted servers.
Ein Werkzeug, das sich in der eigenen Beschreibung „nur lesend“ oder „harmlos“ nennt, hat sich dieses Etikett nicht verdient. Ihre Risikoeinstufung muss deshalb Ihre eigene sein und nicht vom Werkzeug übernommen werden.
Die OWASP-Empfehlung gegen Prompt-Injection geht in dieselbe Richtung, mit zwei Sätzen, die zusammengehören (englische Originalzitate):
Restrict the model’s access privileges to the minimum necessary for its intended operations.
Implement human-in-the-loop controls for privileged operations to prevent unauthorized actions.
Quelle: OWASP LLM01:2025 Prompt Injection. Beachten Sie die Reihenfolge: erst verkleinern, was das Modell kann, dann einen Menschen auf die privilegierten Operationen setzen. Nicht auf alles.
Warum „alles freigeben“ nach hinten losgeht
Freigabemüdigkeit ist kein Charakterfehler, sie ist vorhersehbar.
- Häufigkeit zehrt an der Aufmerksamkeit. Sind 95 von 100 Rückfragen harmlos, bekommt die hundertste denselben Reflex wie die ersten 99.
- Rückfragen enthalten wenig Information. „
curl https://...ausführen? [j/n]“ gibt kaum etwas zum Urteilen her, also entscheidet die Gewohnheit. - Die Kosten eines „Nein“ sind sichtbar, die eines „Ja“ nicht. Ablehnen blockiert die Aufgabe und verärgert Kollegen; Genehmigen kostet heute nichts.
- Es skaliert schlecht. Ein Team mit zehn Agenten und drei Freigebenden kann nicht jede Anfrage lesen.
Eine Kontrolle, die Menschen systematisch aushebeln, ist eine Belastung. Sie verschiebt außerdem die Schuld auf die Person, die geklickt hat, das Gegenteil des schuldzuweisungsfreien Vorgehens, das Sie bei der Incident Response wollen.
Stattdessen nach Risiko routen
Legen Sie vorab fest, welche Aktion welche Behandlung bekommt, und machen Sie das Routing deterministisch.
| Risiko | Beispiele | Behandlung |
|---|---|---|
| Niedrig | Lesende Abfragen im Geltungsbereich, Formatierung, lokale Berechnungen | Per Policy erlauben, keine Rückfrage |
| Mittel | Begrenzte, umkehrbare Schreibaktionen, einen Entwurf anlegen, einen Kommentar ergänzen | Per Policy erlauben und Audit-Eintrag schreiben; gesammelt prüfen |
| Hoch | Unumkehrbare oder externe Wirkung: Zahlungen, Daten löschen, Nachrichten senden, Rechte ändern, Produktions-Deployments | Freigabe durch einen Menschen mit Kontext |
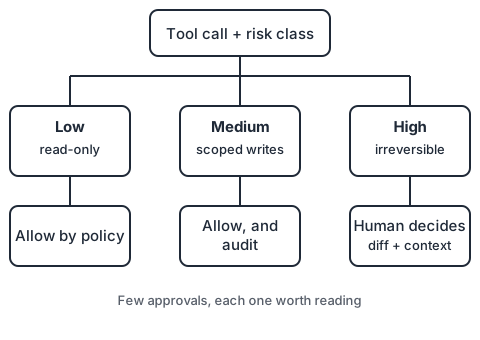
Das Routing ist eine Policy-Frage, keine Modellfrage. Ein deterministisches Gate, das Werkzeug, Argumente und handelnde Identität auswertet, gibt jedes Mal dieselbe Antwort und hinterlässt einen Eintrag. Das ist das Argument aus Policy entscheidet, Audit beweist. Das Modell sollte nie selbst entscheiden, ob seine eigene Aktion eine Freigabe braucht.
Die verbleibenden Freigaben gut machen
Erreicht eine riskante Aktion eine Person, sollte der Freigabebildschirm fünf Fragen beantworten, ohne dass ein Gang in die Logs nötig ist:
- Was genau passiert? Die konkrete Änderung als Diff, gerenderte Nachricht oder exakter Datensatz, nicht ein Funktionsname.
- Warum jetzt? Aufgabe und Schritt, der zu diesem Aufruf führte, in einem Satz.
- Wie groß ist der Wirkungsradius? Wie viele Datensätze, welche Umgebung, ob umkehrbar.
- Woher stammen die Eingaben? Ob nicht vertrauenswürdiger Text (eine Webseite, eine eingehende Mail) die Argumente beeinflusst hat.
- Welche Optionen gibt es? Genehmigen, ablehnen mit einer Begründung, die zum Agenten zurückgeht, oder mit engerem Umfang genehmigen.
Zwei weitere Praktiken helfen. Geben Sie Freigebenden eine Frist und einen sicheren Standard: Entscheidet niemand im Zeitfenster, läuft die Aktion nicht. Und trennen Sie Freigebende von Anfragenden bei sensiblen Aktionen, damit die Person, die den Lauf gestartet hat, nicht die einzige Kontrolle ist.
Eine verwandte Falle ist, den Freigabekanal für Geheimnisse zu nutzen. Die MCP-Spezifikation sagt ausdrücklich, dass solche Interaktionen dafür nicht gedacht sind (englisches Originalzitat; sinngemäß: Server dürfen Elicitation nicht nutzen, um sensible Informationen abzufragen):
Servers MUST NOT use elicitation to request sensitive information.
Quelle: MCP-Spezifikation 2025-06-18, Elicitation. Passwörter und Token gehören in einen Credential-Mechanismus, nicht in eine Rückfrage, die das Modell oder ein Server steuert.
Das Rückfragevolumen durch Grenzen senken
Die meisten Freigabeanfragen existieren, weil das System sicher und unsicher nicht unterscheiden kann. Eine Sandbox gibt ihm dafür ein Mittel. In Agenten in die Sandbox ging es um Dateisystem- und Netzwerkisolation; unter dem Freigabeaspekt gilt: Aktionen innerhalb der Grenze brauchen keine Rückfrage. Die Messung von Anthropic aus der eigenen Nutzung (englisches Originalzitat):
In our internal usage, we’ve found that sandboxing safely reduces permission prompts by 84%.
Quelle: Anthropic, Making Claude Code more secure and autonomous with sandboxing. Die Zahl ist die Erfahrung eines Teams, Ihre Werte werden abweichen, aber die Richtung zählt. Derselbe Artikel hält fest, dass wirksames Sandboxing sowohl Dateisystem- als auch Netzwerkisolation braucht. Zusammen mit engen Werkzeugfreigaben wird „einen Menschen fragen“ zur Ausnahme, und nur so behält es seine Bedeutung.
Wie Sie messen, ob Ihre Freigaben funktionieren
Behandeln Sie den Freigabeprozess wie jede andere Kontrolle und messen Sie ihn.
- Genehmigungsquote. Werden 99 Prozent der Anfragen genehmigt, trägt die Rückfrage vermutlich kein Risiko; machen Sie daraus eine Policy-Regel oder eine protokollierte Erlaubnis.
- Zeit bis zur Entscheidung. Freigaben nach ein oder zwei Sekunden sind Reflexe.
- Ablehnungen und Änderungen. Ein gesunder Ablauf hat welche. Keine Ablehnung über Monate bedeutet entweder perfekte Agenten oder dass niemand liest.
- Vorfälle nach Freigaben. Welche genehmigten Aktionen machten später Ärger, und zeigte der Freigabebildschirm die relevante Tatsache?
Machen Sie regelmäßig eine Stichprobe: Nehmen Sie zwanzig aktuelle Freigaben und fragen Sie die Freigebenden, ob sie ohne Nachsehen sagen können, was sie genehmigt haben.
Wann der Mensch bleiben sollte
Einige Aktionen sollten immer eine Person haben: unumkehrbares Löschen, Geldbewegungen, Änderungen an Rechten und an der Policy selbst sowie alles, was regulierte Daten berührt und wofür eine Person verantwortlich sein muss. Investieren Sie hier in die Freigabeoberfläche, statt sie wegzuautomatisieren. Ziel ist nicht, Menschen zu entfernen, sondern ihre Aufmerksamkeit dorthin zu lenken, wo sie das Ergebnis verändert.
Wichtigste Punkte
- Die MCP-Spezifikation verlangt die Möglichkeit abzulehnen, nicht die Bestätigung jedes Aufrufs.
- Alles freigeben zu lassen trainiert Menschen, ohne Lesen zu genehmigen; das ist schlechter als keine Rückfrage.
- Nach Risiko routen: niedriges per Policy erlauben, mittleres mit Audit erlauben, hohes an eine Person.
- Freigebenden die konkrete Änderung, den Grund, den Wirkungsradius, die Herkunft der Eingaben und die Optionen zeigen.
- Sandboxing und enge Freigaben senken das Rückfragevolumen; Genehmigungsquote und Entscheidungszeit messen.
Quellen
- Model Context Protocol, Tools, Spezifikation 2025-06-18.
- Model Context Protocol, Elicitation, Spezifikation 2025-06-18.
- OWASP Gen AI Security Project, LLM01:2025 Prompt Injection.
- Anthropic, Making Claude Code more secure and autonomous with sandboxing (2025).