Model Drift bei Agenten erkennen und behandeln
Agenten verhalten sich anders, wenn sich Modelle, Prompts, Tools oder Eingaben ändern. Wie Golden Runs und Laufmetriken das zeigen und wie Pinning, Canaries und Rollback helfen.
Dieser Beitrag ist auch auf English verfügbar.
Ein Agent, der letzten Monat funktioniert hat, kann sich heute anders verhalten, ohne dass jemand seine Definition angefasst hat. Das Modell hinter einem Alias wurde aktualisiert, die API eines Tools liefert ein neues Feld, die Eingaben sehen anders aus, oder eine kleine Prompt-Änderung hatte mehr Wirkung als gedacht. In Agentensystemen zeigt sich das selten als Fehler. Es zeigt sich als mehr Schritte je Lauf, höhere Kosten, mehr Wiederholungen, mehr abgelehnte Ergebnisse oder Antworten, die unauffällig schlechter sind. Drift zu erkennen heißt deshalb, Verhalten zu messen und nicht nur Verfügbarkeit; Drift zu behandeln heißt, genau sagen zu können, was sich geändert hat, und zurückgehen zu können.
Dieser Beitrag beschreibt, woher Drift kommt, wie Golden Runs und Laufmetriken sie sichtbar machen und wie Pinning, Canaries und Rollback sie eindämmen.
Vier Quellen von Drift
„Model Drift“ wird locker verwendet. Bei Agenten lohnt es sich, vier Quellen zu trennen, weil jede eine andere Antwort braucht:
- Modelländerungen beim Anbieter. Ein Alias wie „latest“ zeigt auf ein neues Modell, ein gehostetes Modell wird abgekündigt, oder die Bereitstellung ändert sich. Anbieter haben Störungsberichte veröffentlicht, in denen die Antwortqualität eine Zeit lang ohne Ausfall nachließ; Agenten-Änderungen sicher ausrollen zitiert einen davon. Lokale Laufzeiten sind nicht ausgenommen: Ein Modell-Tag kann auf neue Gewichte umgestellt werden.
- Eigene Änderungen. System-Prompts, Anweisungsdateien, Skills, Tool-Beschreibungen, Policies und Budgets. Jede davon kann Ergebnisse ändern, und sie ändern sich öfter als das Modell.
- Änderungen der Umgebung. Ein Tool liefert ein anderes Format, ein MCP-Server bietet neue Tools an, eine Abhängigkeit hinter einem Tool verhält sich anders.
- Drift der Eingaben. Die Ereignisse, die der Agent erhält, ändern sich: neue Ticketarten, längere Dokumente, eine neue Sprache. Nicht der Agent hat sich geändert, sondern die Arbeit.
Die ersten beiden lassen sich mit einer Release-Steuerung erfassen, wenn Sie sie einrichten. Die letzten beiden nicht; deshalb kann sich die Erkennung nicht allein auf Release Notes stützen.
Erkennung 1: Golden Runs
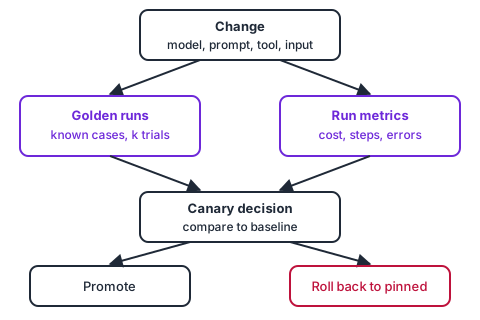
Ein Golden Run ist eine feste Aufgabe mit bekanntem guten Ergebnis, die Sie gezielt erneut ausführen. Eine Sammlung davon ist das Gegenstück einer Regressionstest-Suite für Agenten; die Grundlagen stehen in Agent Evals 101. Für Drift zählen drei Eigenschaften:
- Aus echter Arbeit. Nutzen Sie frühere Eingaben (anonymisiert oder mit erfundenen Daten) und das Ergebnis, das ein Mensch akzeptiert hat, keine ausgedachten Beispiele, auf die der Agent abgestimmt wurde.
- Am Ergebnis bewertet. Prüfen Sie, was der Agent in der Umgebung getan hat (Ticketstatus, Diff, strukturierte Ausgabe), nicht, wie seine letzte Nachricht klingt. Wenn Sie ein Modell als Bewerter brauchen, beachten Sie dessen bekannte Verzerrungen.
- Bei jeder Änderung und nach Zeitplan wiederholt. Bei jeder Änderung, die Sie steuern (Modellkennung, Prompt, Skill, Tool-Version), und regelmäßig auch dann, wenn sich nichts geändert hat, weil Anbieter und Umgebung sich ohne Ankündigung ändern können.
Agentenläufe sind nicht deterministisch; ein einzelnes Bestanden oder Durchgefallen sagt wenig. Führen Sie jeden Fall mehrmals aus, vergleichen Sie Bestehensquoten und behalten Sie den Unterschied zwischen „besteht mindestens einmal in k Versuchen“ und „besteht in allen k Versuchen“ im Blick; für unbeaufsichtigte Agenten zählt meist das Zweite.
Ein minimaler Golden-Fall könnte so aussehen (erfundene Daten):
id: triage-007
input:
  finding: { cveId: CVE-2026-00000, package: example-lib, severity: HIGH }
  ticket: SEC-123
expect:
  output.severity: HIGH
  output.action: comment
  tools_called: [cve-db.lookup_cve, tickets.add_comment]
  max_steps: 6
trials: 5
pass_rule: all   # every trial must pass
Erkennung 2: Laufmetriken gegen eine Basislinie
Golden Runs finden Drift bei Fällen, die Sie kennen. Produktionsmetriken finden Drift bei Fällen, die Sie nicht kennen. Nützliche Signale, je Agentenversion und je Modell:
| Metrik | Worauf eine Verschiebung hindeuten kann |
|---|---|
| Kosten und Tokens je Lauf | Längeres Nachdenken, mehr Wiederholungen, größerer Kontext |
| Schritte und Tool-Aufrufe je Lauf | Schleifen, ein anderer Plan, ein Tool, das nicht mehr funktioniert |
| Fehlerquote der Tool-Aufrufe | Geänderte Tool-API, fehlerhafte Argumente |
| Schemaverstöße der Ausgaben | Das Modell hält das Ausgabeformat nicht mehr ein |
| Stopps durch Budget oder Schleifenerkennung | Läufe, die nicht mehr zum Ende kommen |
| Abgelehnte Freigaben und menschliche Nacharbeit | Die Qualität sank dort, wo Menschen sie sehen |
| Laufzeit | Langsamerer Anbieter, mehr Schritte, Wiederholungen |
Vergleichen Sie Verteilungen über ein Zeitfenster (Median und ein hohes Perzentil), nicht einzelne Läufe, und vergleichen Sie dieselbe Agentenversion bei gleichartigen Eingaben. Mehr Schritte je Lauf bei gleichbleibender Fehlerquote erzählen eine andere Geschichte als mehr Tool-Fehler. Leiten Sie Alarmschwellen aus Ihrer eigenen Basislinie ab; eine allgemeingültige Zahl gibt es nicht. SLOs für Agenten und Observability für Agenten beschreiben, wie Sie diese Signale erfassen.
Behandlung 1: festlegen und protokollieren
Über Drift können Sie nur nachdenken, wenn jeder Lauf festhält, womit er lief:
- die genaue Modellkennung (eine datierte Version, wo der Anbieter sie anbietet, ein Digest bei lokalen Modellen),
- der Anbieter oder Weg, der sie bedient hat (wichtig, wenn ein Router verschiedene Anbieter im Hintergrund wählen kann),
- die Version von Agentendefinition, Prompt, Skills, Tools und Policy.
Pinning verhindert keine Änderungen beim Anbieter, und datierte Versionen werden irgendwann abgekündigt. Es liefert aber einen klaren Zeitpunkt der Änderung: Ein Modellwechsel wird zu einem Release, das Sie planen und bewerten, statt zu etwas, das Ihnen passiert.
Behandlung 2: Canary, vergleichen, zurückrollen
Behandeln Sie eine Modell- oder Prompt-Änderung wie jedes andere Release: Lassen Sie die neue Version neben der stabilen auf einem kleinen Teil der Läufe arbeiten, vergleichen Sie die Bestehensquoten der Golden Runs und die Metriken oben, dann übernehmen oder zurückrollen. Den Ablauf beschreibt Agenten- Änderungen sicher ausrollen Schritt für Schritt. Zwei Punkte sind für Drift besonders wichtig:
- Ein Rollback braucht ein Ziel. Ist die alte Modellversion abgekündigt, heißt Rollback: auf ein anderes festgelegtes Modell wechseln und die Golden Runs wiederholen. Halten Sie deshalb mindestens ein bewertetes Ausweichmodell bereit.
- Nicht jede Drift ist ein Fall für ein Rollback. Drift der Eingaben braucht neue Golden-Fälle und vielleicht ein geändertes Playbook, kein älteres Modell. Drift der Umgebung braucht einen Fix im Tool oder in seinem Vertrag.
Ist Drift durchgerutscht und hat Schaden angerichtet, behandeln Sie das als Vorfall: Agent stoppen, Spuren sichern, aufarbeiten. Siehe Incident Response für Agenten.
Was openagentix heute erfasst und was geplant ist
openagentix ist Open Source und noch vor 1.0, daher ein kurzer, ehrlicher Stand:
- Vorhanden: Veröffentlichte
agents.md-Versionen sind unveränderlich; die Definition hinter einem Lauf steht also fest. Jeder Laufschritt erfasst Anbieter, Modell, Tokens, Kosten und Dauer. Typisierte Übergaben lassen einen Lauf scheitern, wenn eine Ausgabe nicht zu ihrem Schema passt, und der Fehler wird erfasst. Budgets stoppen Läufe, die Tokens, Kosten, Schritte oder Zeit überschreiten. Modellpreise stammen aus einem festgelegten, eingebundenen models.dev-Snapshot (das legt Katalogdaten fest, nicht das Verhalten eines Modells). - Geplant: Agenten-Testsuiten und ein Eval-Runner bei jeder Veröffentlichung (W2-4), Golden-Datensätze mit Bewertern und einem Promotion-Gate für jede neue Version und jedes neue Modell (W6-2) sowie eine Freigabe einer Version, die an Modell, Evaluationssatz und Policy gebunden ist und bei jeder Änderung daran neu bewertet wird (W6-3). Siehe die Roadmap.
Bis es diese gibt, lassen sich die Signale oben aus den Datensätzen der Laufschritte und den
Kostenzeilen lesen (die sich als CSV oder JSON exportieren lassen), und Golden Runs lassen sich mit dem
Befehl oax run gegen feste Ereignisdateien skripten.
Eine Checkliste
- Schreiben Sie jedes Artefakt auf, das das Verhalten des Agenten prägt, und legen Sie jedes fest.
- Protokollieren Sie Modell, Anbieter und Artefaktversionen bei jedem Lauf.
- Bauen Sie einen Golden-Satz aus echten, akzeptierten Ergebnissen; führen Sie jeden Fall mehrmals aus.
- Wiederholen Sie ihn bei jeder Änderung und nach Zeitplan.
- Erfassen Sie Basislinien für Kosten, Schritte, Tool-Fehler, Schemaverstöße, Budgetstopps und menschliche Ablehnungen je Version.
- Rollen Sie Modell- und Prompt-Änderungen als Canary aus; halten Sie ein bewertetes Ausweichmodell bereit.
- Ergänzen Sie neue Golden-Fälle, sobald sich in der Produktion Drift der Eingaben zeigt.
Das Wichtigste in Kürze
- Drift kommt von Anbietermodellen, eigenen Änderungen, der Umgebung und den Eingaben; trennen Sie diese Quellen.
- Sie zeigt sich meist als verändertes Verhalten und veränderte Kosten, nicht als Fehler; messen Sie Verhalten.
- Golden Runs finden Drift bei bekannten Fällen; Laufmetriken gegen eine Basislinie finden den Rest.
- Legen Sie alles fest, was einen Lauf prägt, und protokollieren Sie es, damit eine Änderung zu einem Release wird.
- Canary und Rollback helfen bei Änderungen, die Sie steuern; Drift der Eingaben und der Umgebung braucht stattdessen neue Fälle und Fixes.
Quellen
- openagentix, Roadmap (Punkte W2-4, W6-2, W6-3) und Repository.
- Verwandte Beiträge in diesem Blog: Agent Evals 101, Agenten-Änderungen sicher ausrollen, SLOs für Agenten.