Betriebsreihe: LLM FinOps für Agenten, jedes Token zuordnen
LLM FinOps überträgt das Cloud-Vorgehen auf Agenten: Läufe taggen, Kosten je Key und Team zuordnen, Budgets setzen, früh warnen, Nutzung exportieren.
Dieser Beitrag ist auch auf English verfügbar.
LLM FinOps heißt, Modellkosten wie jede andere Cloud-Ausgabe zu behandeln: jeden Lauf taggen, jedes Token einem Verantwortlichen zuordnen, Budgets setzen, vor der Überschreitung warnen und die Zahlen regelmäßig prüfen. Die Technik ist nicht exotisch. Tracking pro Schlüssel in einem Gateway und OpenTelemetry-Export aus Coding-Agenten decken das meiste ab. Dieser Beitrag gehört zu unserer Betriebsreihe und zeigt ein praxistaugliches Setup.
Der FinOps-Kreislauf für Agenten
Cloud-FinOps lässt sich auf fünf Verben reduzieren, die sich unverändert übertragen lassen:
- Taggen. Jeder Aufruf trägt Labels, die sagen, wem und was er gehört.
- Zuordnen. Kosten werden nach diesen Labels gruppiert: Mandant, Team, Agent, Anwendungsfall.
- Budgetieren. Jede Gruppe erhält ein Limit, festgelegt von denen, die zahlen.
- Warnen. Jemand erfährt es bei 50, 80 und 100 Prozent, nicht am Rechnungstag.
- Prüfen. Ein wiederkehrender Termin schaut auf Ausreißer und entscheidet über Änderungen.
Bei Agenten kommt hinzu, dass eine einzelne Nutzeranfrage in viele Modell- und Werkzeugaufrufe zerfällt. Die Zuordnung muss deshalb auf Ebene eines Laufs funktionieren, nicht eines einzelnen API-Requests. Warum das in die Plattform gehört und nicht in jede Anwendung, steht in Kosten sind eine Aufgabe der Plattform.
Warum eine Obergrenze Pflicht ist
Agenten laufen in Schleifen. Ein Wiederholversuch, der nie konvergiert, ein Werkzeug mit riesiger Ausgabe, ein Prompt, der mit jeder Runde wächst: Jedes davon macht aus einer günstigen Aufgabe eine teure, ganz ohne Angreifer. OWASP führt diese Problemklasse als eigenes Risiko:
Unbounded Consumption occurs when a Large Language Model (LLM) application allows users to conduct excessive and uncontrolled inferences
Quelle: LLM10:2025 Unbounded Consumption, OWASP Gen AI Security Project. Sinngemäß: Unbegrenzter Verbrauch entsteht, wenn eine LLM-Anwendung übermäßige und unkontrollierte Inferenz zulässt. Die Seite behandelt das auch als Sicherheitsthema (Dienstverweigerung, Kostenerschöpfung). Ein guter Grund, Sicherheit und Finanzen an einen Tisch zu holen.
Kostenverfolgung pro Schlüssel und Team
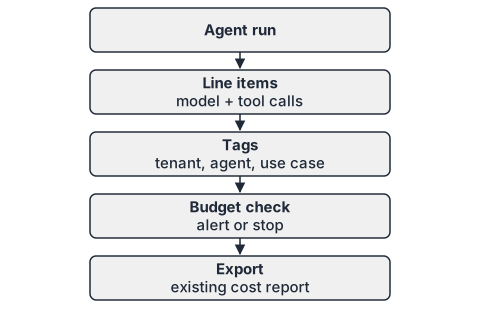
Der einfachste Zuordnungsmechanismus ist ein Zugangsschlüssel pro Verbraucher. Ruft jedes Team, jeder Agent oder Anwendungsfall das Modell über einen eigenen Schlüssel auf, kann der Anbieter oder Ihr Gateway die Kosten je Schlüssel summieren. Der LiteLLM-Proxy dokumentiert das als Virtual Keys:
Spend is automatically tracked for the key
Quelle: Virtual Keys, LiteLLM docs, lebende Dokumentation, Wortlaut Stand 2026-10-04. Sinngemäß: Die Ausgaben werden automatisch pro Schlüssel erfasst. Ein Schlüssel kann ein Budget und Metadaten tragen, sodass dasselbe Objekt beantwortet, wie viel ein Verbraucher ausgegeben hat und wann gestoppt wird. Wenn Sie eigene Anbieter-Schlüssel mitbringen, finden Sie die Abwägung zwischen Tracking beim Anbieter und in der Plattform in BYOK erklärt.
Eine Konfigurationsskizze für einen Gateway-Schlüssel (Feldnamen unterscheiden sich je Produkt, prüfen Sie die Dokumentation Ihres Gateways):
{
  "key_alias": "support-triage-prod",
  "max_budget": 250.0,
  "budget_duration": "30d",
  "metadata": {
    "tenant": "example-tenant",
    "team": "support",
    "agent": "triage",
    "use_case": "ticket-classification"
  }
}
Drei Gewohnheiten machen das nutzbar:
- Ein Schlüssel pro Agent und Umgebung. Teilen sich Produktion und Experimente einen Schlüssel, sind die Zahlen wertlos.
- Stabiles Tag-Vokabular. Einigen Sie sich auf Mandant, Team, Agent und Anwendungsfall und schreiben Sie die erlaubten Werte auf. Freitext-Tags zerfasern schnell (“support”, “Support”, “support-team”).
- Schlüssel sind Zugangsdaten. Rotieren Sie sie, begrenzen Sie ihre Rechte und legen Sie sie nie in Prompts oder Logs ab.
Nutzung aus Coding-Agenten exportieren
Entwicklerwerkzeuge brauchen dieselbe Behandlung. Claude Code kann Telemetrie über OpenTelemetry exportieren. Die Monitoring-Dokumentation beschreibt den Zweck:
Track Claude Code usage, costs, and tool activity across your organization by exporting telemetry data through OpenTelemetry (OTel).
Quelle: Monitoring, Claude Code docs, lebende Dokumentation, Wortlaut Stand 2026-10-04. Sinngemäß: Nutzung, Kosten und Werkzeugaktivität lassen sich organisationsweit über OpenTelemetry-Export verfolgen. Da die Daten als Standard-OTel-Metriken und -Ereignisse ankommen, schicken Sie sie an den Collector und das Backend, die Sie ohnehin betreiben, und ergänzen dort Team- und Kostenstellen-Labels. Eine minimale Collector-Pipeline:
receivers:
  otlp:
    protocols:
      grpc: {}
processors:
  batch: {}
  attributes/team:
    actions:
      - key: team
        value: platform
        action: upsert
exporters:
  prometheus:
    endpoint: 0.0.0.0:8889
service:
  pipelines:
    metrics:
      receivers: [otlp]
      processors: [attributes/team, batch]
      exporters: [prometheus]
Metriknamen und Umgebungsvariablen Ihrer Version stehen auf der Monitoring-Seite; übernehmen Sie keine Namen aus einem Blogbeitrag, auch nicht aus diesem.
Budgetprüfungen und Warnungen
Tracking sagt, was passiert ist; Budgets ändern, was als Nächstes passiert. Eine brauchbare Regel:
- Weiches Limit bei 80 Prozent: Inhaber des Schlüssels und Team-Kanal benachrichtigen.
- Hartes Limit bei 100 Prozent: neue Läufe für diesen Schlüssel blockieren oder die Freigabe einer benannten Person verlangen.
- Obergrenze pro Lauf: einen einzelnen Lauf stoppen, der ein Vielfaches der üblichen Kosten seines Anwendungsfalls überschreitet. So werden Schleifen lange vor dem Monatsbudget erkannt.
Prompt-Caching und Token-Budgets senken die Grundkosten und stehen in Prompt-Caching und Token-Budgets. Beides ergänzt sich: Caching senkt den Preis eines Laufs, das Budget begrenzt den Schaden, wenn ein Lauf entgleist.
Reporting und Chargeback
Die Finanzabteilung will kein weiteres Dashboard. Exportieren Sie die zugeordnete Nutzung als Tabelle, die sich in das bestehende Kostenreporting laden lässt:
month,tenant,team,agent,use_case,model,input_tokens,output_tokens,cost
2026-07,example-tenant,support,triage,ticket-classification,model-a,18200000,2100000,142.80
Entscheiden Sie früh, ob es Showback (Teams sehen ihre Kosten) oder Chargeback (Kosten werden ihrem Budget belastet) sein soll. Showback ist der leichtere Einstieg und reicht oft, um Verhalten zu ändern. Führen Sie eine Zeile für nicht zugeordnete Kosten und beobachten Sie sie: Ein wachsender Posten “unbekannt” zeigt Lücken beim Tagging.
Grenzen dieses Ansatzes
- Tags sind nur so gut wie die Disziplin dahinter; ungetaggte Aufrufe landen bei “unbekannt”.
- Gemeinsam genutzte Infrastruktur (Embedding-Dienste, Vektorspeicher, Evaluationsläufe) braucht eine Regel für die Kostenaufteilung.
- Tokenkosten sind nicht die Gesamtkosten: Prüfaufwand von Menschen, Wiederholungen und Rechenzeit auf Werkzeugseite fehlen in diesen Zahlen.
- Preise und Abrechnungseinheiten unterscheiden sich je Anbieter; prüfen Sie sie in der aktuellen Preisliste, statt sie fest zu verdrahten.
Das Wichtigste in Kürze
- Den Cloud-Kreislauf anwenden: taggen, zuordnen, budgetieren, warnen, prüfen.
- Einen Schlüssel pro Agent und Umgebung nutzen, damit sich Kosten je Verbraucher summieren lassen.
- Telemetrie aus Coding-Agenten per OpenTelemetry in den vorhandenen Stack exportieren.
- Monatsbudgets mit einer Obergrenze pro Lauf kombinieren, um Schleifen früh zu erkennen.
- Im Format berichten, das die Finanzabteilung schon nutzt, und den Anteil nicht zugeordneter Kosten verfolgen.
Quellen
- Virtual Keys (LiteLLM docs), lebende Dokumentation, Wortlaut Stand 2026-10-04.
- Monitoring (Claude Code docs, Anthropic), lebende Dokumentation, Wortlaut Stand 2026-10-04.
- LLM10:2025 Unbounded Consumption (OWASP Gen AI Security Project)