LLM Cost Optimization für Agenten: Caching, Code-Ausführung und Budgets
LLM Cost Optimization für Agenten: wann Prompt Caching lohnt, wann Code-Ausführung Tool-Aufrufe schlägt und warum harte Token-Budgets auch Sicherheit sind.
Dieser Beitrag ist auch auf English verfügbar.
LLM Cost Optimization für Agenten läuft auf drei Hebel hinaus: nicht mehr den vollen Preis für Kontext zahlen, den Sie immer wieder senden (Prompt Caching), große Zwischenergebnisse nicht durch das Modell schleusen (Code-Ausführung und kompakte Werkzeugergebnisse) und eine harte Obergrenze setzen, was ein einzelner Lauf ausgeben darf (Token-Budgets). Die ersten beiden senken die Rechnung. Der dritte schützt Sie, wenn die ersten beiden nicht reichen, und ist zugleich eine Sicherheitskontrolle. Dieser Beitrag zeigt, wo jeder Hebel hilft, mit Zahlen aus der Dokumentation der Anbieter, und was Sie bei sich messen sollten.
Woher die Kosten eines Agenten kommen
Ein Agentenlauf ist eine Schleife. Jeder Schritt sendet die gesamte bisherige Unterhaltung samt Werkzeugdefinitionen an das Modell und erhält eine neue Nachricht. Zwei Dinge treiben die Rechnung:
- Wiederholter Kontext. System-Prompt, Werkzeugdefinitionen, Anweisungen und der frühe Teil der Unterhaltung gehen bei jedem Schritt erneut raus. Ein Lauf mit zwanzig Schritten zahlt den System-Prompt zwanzigmal.
- Große Zwischenergebnisse. Ein Werkzeug liefert eine Tabelle mit zehntausend Zeilen oder eine ganze Datei; das Modell liest sie, nutzt einen Bruchteil, und der Rest bleibt für jeden weiteren Schritt im Kontext.
Den größeren Rahmen liefert Kosten sind eine Aufgabe der Plattform: Zuordnung und Limits gehören in die Plattform und nicht zu den Autoren einzelner Agenten. Die folgenden Techniken sind das Handwerkszeug dafür.
Hebel 1: Prompt Caching
Prompt Caching lässt einen Anbieter die verarbeitete Form eines stabilen Prompt-Präfixes wiederverwenden, sodass das erneute Senden weniger kostet und die Antwort schneller kommt. Die Ankündigung von Anthropic fasst den Tausch zusammen (englisches Originalzitat; sinngemäß: Kosten um bis zu 90 % und Latenz um bis zu 85 % bei langen Prompts senken):
reducing costs by up to 90% and latency by up to 85% for long prompts.
Auf der Schreibseite gibt es einen Haken, in derselben Ankündigung benannt (englisches Originalzitat; sinngemäß: Das Schreiben in den Cache kostet 25 % mehr als der Basispreis für Eingabetokens):
Writing to the cache costs 25% more than our base input token price for any given model
Quelle: Anthropic, Prompt caching with Claude. Preise und Bedingungen ändern sich, prüfen Sie also die aktuellen Zahlen für Ihr Modell. Die Struktur des Tauschs bleibt: Das Schreiben in den Cache kostet einmal etwas mehr, das Lesen bei jeder späteren Nutzung deutlich weniger. Caching lohnt sich also, wenn dasselbe Präfix innerhalb der Cache-Lebensdauer mehrfach genutzt wird, und verliert, wenn jedes Präfix nur einmal vorkommt.
Praktisch heißt das:
- Stabiles zuerst, Veränderliches zuletzt. Caching wirkt auf ein Präfix. Setzen Sie Systemanweisungen, Werkzeugdefinitionen und Referenzdokumente an den Anfang und den wechselnden Nutzerzug ans Ende. Ein Zeitstempel oder eine Anfrage-ID weit oben macht den Cache zunichte.
- Werkzeugdefinitionen stabil halten. Umsortieren oder Ändern von Werkzeugen zwischen Schritten entwertet alles danach. Laden Sie für einen ganzen Lauf denselben Satz, statt je Schritt umzusortieren.
- Frühere Züge nicht ändern. Wer die Historie zum „Aufräumen“ umschreibt, bricht das Präfix. Hängen Sie lieber an und verdichten Sie bewusst an festgelegten Stellen.
- Trefferquote messen. Die meisten APIs melden Cache-Lesen und -Schreiben im Nutzungsblock. Protokollieren Sie sie je Lauf und alarmieren Sie bei fallender Quote; meist hat dann jemand ein Prompt-Präfix geändert.
Wie Sie den Kontext so aufbauen, dass der stabile Teil wirklich stabil ist, steht in Grundlagen des Context Engineering.
Hebel 2: Große Zwischenergebnisse aus dem Modell heraushalten
Direkte Werkzeugaufrufe haben eine eingebaute Ineffizienz: Jedes Werkzeugergebnis läuft durch den Kontext des Modells, ob es alles braucht oder nicht. Anthropic beschreibt das Problem bei großen Werkzeugmengen (englisches Originalzitat; sinngemäß: Sind Agenten mit tausenden Werkzeugen verbunden, müssen sie hunderttausende Tokens verarbeiten, bevor sie eine Anfrage lesen):
In cases where agents are connected to thousands of tools, they’ll need to process hundreds of thousands of tokens before reading a request.
und zeigt, was sich ändert, wenn der Agent Code schreibt, der Werkzeuge aufruft und Daten außerhalb des Modells verarbeitet (englisches Originalzitat; sinngemäß: Der Tokenverbrauch sinkt von 150.000 auf 2.000, eine Zeit- und Kostenersparnis von 98,7 %):
This reduces the token usage from 150,000 tokens to 2,000 tokens—a time and cost saving of 98.7%.
Quelle: Anthropic, Code execution with MCP: building more efficient AI agents. Die Zahl stammt aus einem Beispiel, in dem Daten zwischen Diensten wandern, und ist keine allgemeine Garantie. Wiederverwenden lässt sich der Mechanismus: Lassen Sie Code, nicht das Modell, Massendaten verarbeiten. Das Modell schreibt ein kleines Skript, das holt, filtert und zusammenfasst, und nur die Zusammenfassung kehrt in seinen Kontext zurück.
Wann Code-Ausführung direkte Werkzeugaufrufe schlägt:
- Ein Werkzeug liefert weit mehr Daten, als das Modell braucht (Filtern, Aggregieren, Verknüpfen).
- Sie verketten mehrere Werkzeugaufrufe, deren Zwischenergebnisse nur Eingaben des nächsten Aufrufs sind.
- Sie brauchen Schleifen oder Bedingungen über viele Elemente.
Wann direkte Aufrufe besser sind:
- Ein Aufruf, kleines Ergebnis, und das Modell muss es lesen.
- Die Ausführungsumgebung wäre ein größeres Risiko als die Daten, die sie spart. Das Ausführen erzeugten Codes braucht Isolation, in der Regel eine Sandbox.
Auch ohne Code-Ausführung lassen sich Werkzeuge günstiger machen:
- Kompakte, strukturierte Ergebnisse liefern. Die Felder, die das Modell braucht, nicht volle Datensätze.
- Mit sinnvollen Standardwerten paginieren. Zehn Zeilen und ein „mehr“-Token statt zehntausend Zeilen.
- Eine „Zusammenfassung“- oder „Anzahl“-Variante teurer Listenoperationen anbieten.
- Mit sichtbarer Markierung kürzen. Das Modell sollte wissen, dass die Ausgabe abgeschnitten wurde.
Hebel 3: Harte Token-Budgets
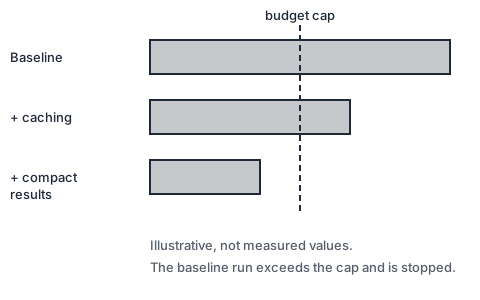
Caching und Verdichtung senken die erwarteten Kosten. Ein Budget begrenzt den schlimmsten Fall. Setzen Sie Limits auf mehreren Ebenen:
| Ebene | Limit | Was es verhindert |
|---|---|---|
| Je Schritt | maximale Ausgabetokens | ausufernde Generierungen |
| Je Lauf | Tokens oder Kosten gesamt, plus maximale Schrittzahl | Schleifen, endlose Wiederholungen |
| Je Agent und Tag | Kostenobergrenze | ein beliebter oder defekter Agent, der das Budget leert |
| Je Mandant oder Nutzer | Quote | eine Partei, die geteilte Kapazität verbraucht |
Setzen Sie Budgets in der Plattform durch, die Modellaufrufe vermittelt, nicht im Prompt. Ein Prompt, der sagt „sei sparsam“, ist ein Vorschlag. Ein Gateway, das den nächsten Aufruf verweigert, sobald der Lauf seine Grenze erreicht, ist eine Kontrolle. Wird ein Limit erreicht, scheitern Sie deutlich: den Lauf stoppen, den Grund festhalten und melden, damit eine Person entscheiden kann, ob sie das Limit anhebt oder die Ursache behebt.
Warum Budgets eine Sicherheitskontrolle sind
Ein Angreifer, oder einfach ein verwirrter Agent, kann Ihr System Ressourcen verbrauchen lassen, ohne eine verbotene Aktion auszuführen. OWASP benennt diese Problemklasse (englisches Originalzitat; sinngemäß: Unbegrenzter Verbrauch entsteht, wenn eine LLM-Anwendung übermäßige und unkontrollierte Inferenz zulässt):
Unbounded Consumption occurs when a Large Language Model (LLM) application allows users to conduct excessive and uncontrolled inferences
Quelle: OWASP LLM10:2025 Unbounded Consumption. Die finanzielle Form heißt manchmal Denial of Wallet: präparierte Eingaben, die lange Schleifen, riesige Kontexte oder das Auffächern auf viele Subagenten auslösen, sodass Sie den Verkehr des Angreifers bezahlen. Eine Obergrenze je Lauf, ein Schrittlimit und eine Auffächerungsgrenze begrenzen den Schaden. Dieselben Limits halten einen harmlosen, aber fehlerhaften Agenten davon ab, ein ganzes Wochenende zu laufen. Auch deshalb braucht ein Multi-Agenten-Entwurf ein Budget, das an die Worker weitergegeben wird: Unbegrenztes Auffächern vervielfacht jeden anderen Kostenfaktor.
Eine praktische Reihenfolge
- Zuerst messen. Protokollieren Sie Eingabe-, Ausgabe-, Cache-Lese- und Cache-Schreibtokens je Schritt und Lauf. Finden Sie die fünf teuersten Läufe und lesen Sie sie.
- Das Präfix reparieren. Prompts so ordnen, dass der stabile Teil vorn steht; flüchtige Werte vom Anfang entfernen.
- Werkzeugergebnisse trimmen. Suchen Sie Schritte, in denen ein großes Ergebnis für einen kleinen Fakt genutzt wurde.
- Code-Ausführung erwägen für datenlastige Abläufe, hinter einer Sandbox.
- Budgets setzen auf Schritt-, Lauf- und Tagesebene. Großzügig beginnen, mit Daten verschärfen.
- Alarmieren bei Budgettreffern und bei fallender Cache-Trefferquote.
Wichtigste Punkte
- Der größte Teil der Agentenkosten ist wiederholter Kontext und sperrige Werkzeugergebnisse.
- Prompt Caching tauscht einen kleinen Aufschlag beim Schreiben gegen große Einsparungen beim Lesen; strukturieren Sie Prompts mit stabilem Präfix und prüfen Sie die Treffer in den Nutzungsdaten.
- Code Massendaten verarbeiten zu lassen kann den Tokenverbrauch stark senken; die genannten 98,7 % sind ein Beispiel, kein Versprechen.
- Harte Budgets je Lauf und Tag, außerhalb des Modells durchgesetzt, begrenzen den schlimmsten Fall und schützen vor unbegrenztem Verbrauch.
Quellen
- Anthropic, Prompt caching with Claude (2025).
- Anthropic, Code execution with MCP: building more efficient AI agents (2025).
- OWASP Gen AI Security Project, LLM10:2025 Unbounded Consumption.