Messen, ob Agenten helfen: Ergebnisse statt Eindrücke
KI-Produktivität messen: Ergebnisse statt Eindrücke, mit akzeptierten Änderungen, Review-Zeit, Nacharbeit und Kosten je akzeptierter Änderung im Metrikbaum.
Dieser Beitrag ist auch auf English verfügbar.
“Es fühlt sich schneller an” ist keine Messung. Wer KI-Produktivität messen will, muss trennen, wie sich Arbeit anfühlt und was die Organisation tatsächlich bekommt: akzeptierte Änderungen, die Dauer der Prüfung, den Anteil der Nacharbeit und die Kosten. Gefühlte und gemessene Geschwindigkeit können auseinanderlaufen, und KI verstärkt tendenziell, was ein Team ohnehin gut oder schlecht macht. Dieser Beitrag schlägt wenige Ergebnismetriken für agentengestützte Arbeit vor, zeigt, wie sie sich aus ohnehin vorhandenen Daten bilden lassen, und nennt die Fallen.
Warum Eindrücke täuschen
Die bekannteste kontrollierte Studie zu dieser Frage stammt von METR und untersuchte erfahrene Open-Source-Entwickler, die an ihren eigenen Repositories arbeiteten:
Surprisingly, we find that when developers use AI tools, they take 19% longer than without—AI makes them slower.
Quelle: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, METR, 10.07.2025. Sinngemäß: Überraschenderweise brauchten Entwickler mit KI-Werkzeugen 19 Prozent länger als ohne.
Zwei Einschränkungen sind wesentlich. Die Seite trägt inzwischen einen Hinweis, dass die Ergebnisse veraltet sind und eine Fortsetzung aus 2026 existiert; die Zahl ist also eine Momentaufnahme von Werkzeugen aus dem frühen Jahr 2025 in einem bestimmten Umfeld, kein aktuelles Urteil. Und der Wert der Studie liegt in der Methode, nicht in der Zahl: Sie verglich tatsächliche Aufgabenzeiten mit dem, was Entwickler erwarteten und im Nachhinein glaubten, und beides wich ab. Gültig bleibt die Lehre, dass Selbstauskünfte ein schwaches Messinstrument sind.
Daten auf Teamebene erzählen Verwandtes. Der DORA-Report 2025 fasst seinen Hauptbefund so zusammen:
AI doesn’t fix a team; it amplifies what’s already there.
Quelle: Announcing the 2025 DORA Report, Google Cloud Blog, 23.09.2025. Sinngemäß: KI repariert kein Team, sie verstärkt, was bereits da ist.
Ist das Review schon ein Engpass, verlagert schnellere Codeerzeugung die Warteschlange dorthin. Sind die Tests schwach, bedeutet mehr generierter Code mehr ungeprüfte Änderung. Messen Sie also das System, nicht nur den Autor.
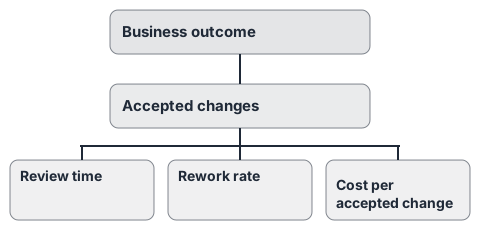
Ein Metrikbaum
Ausgehen vom Geschäftsergebnis und nach unten zu Zahlen, die eine Agentenplattform liefern kann.
- Geschäftsergebnis: der Grund, warum Agenten eingeführt wurden, etwa weniger Tage von der Anfrage bis zur Lieferung, kürzere Ticketbearbeitung oder weniger manuelle Triage. Eines wählen, mit Ausgangswert vor dem Pilot.
- Akzeptierte Änderungen: die Einheit des Nutzens. Eine Änderung ist akzeptiert, wenn eine Person oder ein Gate sie freigegeben hat und sie bestehen blieb. Verworfene Entwürfe sind Kosten ohne Nutzen.
- Review-Zeit: wie lange akzeptierte Änderungen auf die Prüfung warten und in ihr verbringen. Ein Anstieg heißt, dass der Agent Arbeit auf die Prüfenden verlagert.
- Nacharbeitsquote: Anteil der akzeptierten Änderungen, die innerhalb eines festen Zeitraums, etwa 14 Tagen, wieder geöffnet, zurückgenommen oder korrigiert wurden.
- Kosten je akzeptierter Änderung: Gesamtausgaben (Modellnutzung, Plattform, Zeit der Prüfenden, wenn schätzbar) geteilt durch akzeptierte Änderungen. Diese Zahl macht Agenten mit der Alternative vergleichbar.
So werden sie berechnet
- “Akzeptiert” in Ihren Werkzeugen definieren. Zusammengeführter Pull Request ohne Revert, Ticket ohne Wiederöffnung geschlossen, Bericht ohne Korrektur geliefert.
- Drei Quellen verbinden: Laufprotokolle der Agenten (was lief, welcher Agent, welcher Anwendungsfall), das führende System (zusammengeführt, geschlossen, wieder geöffnet) und die Kostendaten.
- Kosten je Anwendungsfall zuordnen, nicht nur je Team. Eine Aufschlüsselung je Agent und Anwendungsfall zeigt, welche Automatisierungen sich tragen.
- Mit einem Ausgangswert vergleichen, idealerweise dieselbe Arbeit ohne Agent im selben Zeitraum oder dasselbe Team vor dem Pilot. Ohne Ausgangswert haben Sie einen Trend, keinen Effekt.
Eine brauchbare Formel:
cost per accepted change = (model cost + platform cost + review minutes x rate)
                           / accepted changes in the period
Beziehen Sie Review-Minuten ein, auch wenn die Schätzung grob ist; sie wegzulassen schmeichelt dem Agenten.
Was Telemetrie sagen kann und was nicht
Nutzungsdaten beantworten “wie viel” und “wo”. Die Dokumentation von Claude Code beschreibt den Export:
Track Claude Code usage, costs, and tool activity across your organization by exporting telemetry data through OpenTelemetry (OTel).
Quelle: Monitoring (Claude Code docs), Live-Dokumentation (Wortlaut Stand 2026-10-04). Sinngemäß: Nutzung, Kosten und Tool-Aktivität lassen sich organisationsweit über einen Export von Telemetriedaten per OpenTelemetry nachverfolgen.
Das liefert Kosten und Aktivität nach Nutzer, Modell und Tool. Ob das Ergebnis gut war, sagt es nicht. Verbinden Sie es mit Ergebnisdaten aus Ihren eigenen Systemen und seien Sie vorsichtig mit Berichten auf Personenebene: Menschen nach Token-Verbrauch oder erzeugten Zeilen zu ordnen belohnt Menge, genau das falsche Signal.
Fallen
- Output zählen. Zeilen, Commits und generierte Dokumente sind Kostentreiber, kein Nutzen.
- Nur Umfragen. Menschen fragen, aber mit gemessenen Zeiten und Ergebnissen gegenprüfen.
- Keine Qualitätsschranke. Steigt die Geschwindigkeit und die Nacharbeit schneller, verschieben Sie Kosten. Jede Geschwindigkeitsmetrik mit einer Qualitätsmetrik koppeln; siehe Qualitäts-Gates für Agenten-Ausgaben.
- Zu früh messen. Werkzeuge und Gewohnheiten ändern sich in den ersten Wochen; einen Pilot lange genug laufen lassen, wie in Enterprise-Rollout: erst der Pilot beschrieben.
- Kostenstruktur ignorieren. Die Ausgaben sind variabel und nutzungsgetrieben; siehe FinOps für Agenten.
Ein Kostenexport als Datenquelle
In der aktuellen Demo listet ein Kostenexport für einen erfundenen Mandanten Zeilen je Agent und je Anwendungsfall in einer CSV-Vorschau auf. Ein solcher Export ist der Nenner der Hauptmetrik und der Verknüpfungsschlüssel für den Rest.
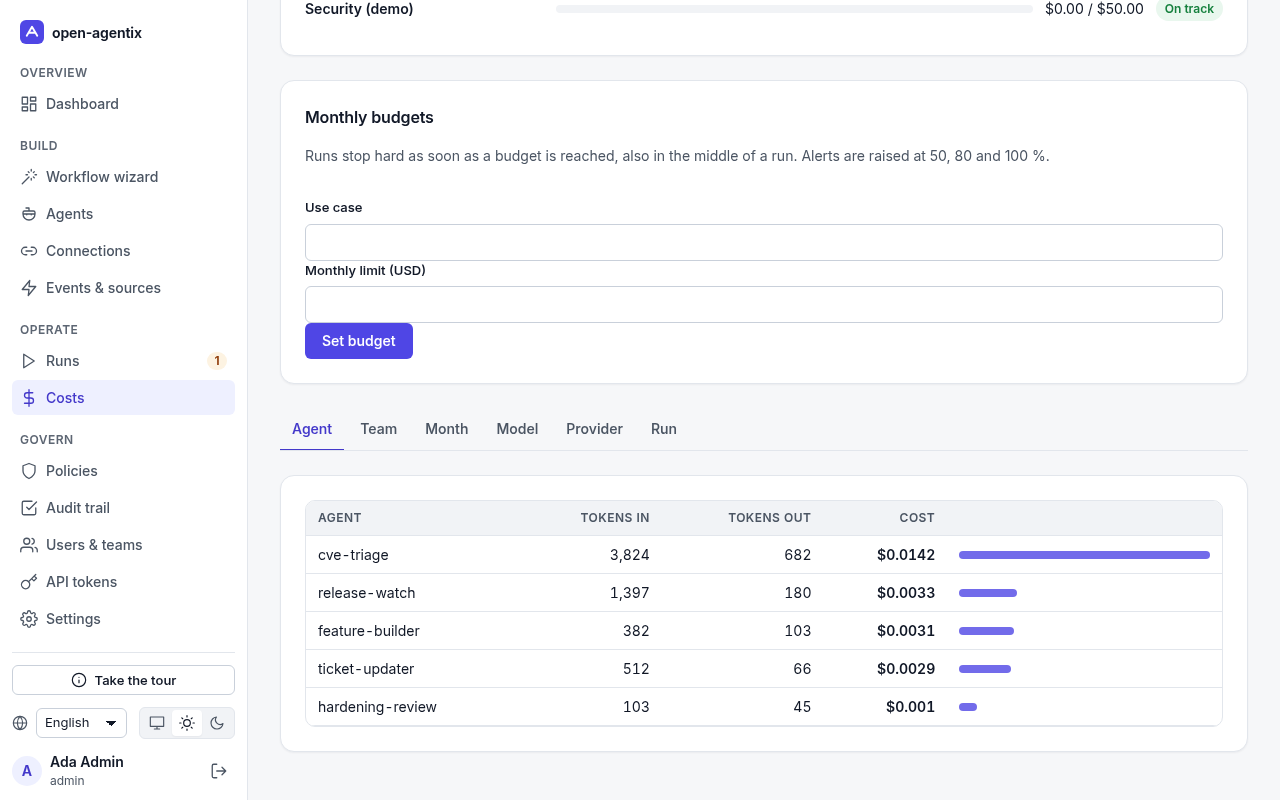
Screenshot der aktuellen Demo (erfundene Daten).
Ein erstes Dashboard
Fünf Zahlen je Anwendungsfall, wöchentlich: akzeptierte Änderungen, mediane Review-Zeit, Nacharbeitsquote nach 14 Tagen, Kosten je akzeptierter Änderung und Anteil der Läufe, die ein Budget oder ein Gate gestoppt hat. Trendlinien gegen den Ausgangswert vor dem Pilot zeigen. Wenn Sie nur ein Diagramm bauen können, bauen Sie Kosten je akzeptierter Änderung über die Zeit.
Das Wichtigste in Kürze
- Gefühlte und gemessene Geschwindigkeit können auseinanderlaufen; Ergebnisse messen.
- Die METR-Zahl ist eine Momentaufnahme von Werkzeugen des frühen Jahres 2025, und die Seite selbst nennt sie veraltet; die Methode ist die Lehre.
- KI verstärkt vorhandene Stärken und Schwächen, also das ganze Liefersystem messen.
- Akzeptierte Änderungen, Review-Zeit, Nacharbeitsquote und Kosten je akzeptierter Änderung gegen einen Ausgangswert verfolgen.
- Jede Geschwindigkeitsmetrik mit einer Qualitätsmetrik koppeln und Personen nicht nach Nutzung ordnen.
Quellen
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 10.07.2025 (Seite als veraltet gekennzeichnet).
- Google Cloud Blog, Announcing the 2025 DORA Report, 23.09.2025.
- Anthropic, Monitoring (Claude Code docs), Live-Dokumentation.