Betriebsreihe: Kapazität, Rate Limits und außer Kontrolle geratene Agenten
LLM Rate Limiting für Agenten: verschachtelte Limits für Lauf, Agent, Mandant und Anbieter verhindern, dass eine Schleife alle ausbremst. Mit Beispiel.
Dieser Beitrag ist auch auf English verfügbar.
Ein Agent in einer Wiederholungsschleife kann in einer Stunde die Tokens eines ganzen Tages verbrauchen und allen anderen Agenten das Rate Limit wegnehmen. LLM-Rate-Limiting für Agenten braucht deshalb mehrere Ebenen: ein Budget je Lauf, eine Quote je Agent, eine Quote je Mandant und, außerhalb Ihrer Kontrolle, das Limit des Anbieters. Jede Ebene fängt einen anderen Fehler ab, und zusammen machen sie Sättigung sichtbar, bevor sie zum Ausfall wird. Dieser Beitrag gehört zur Betriebsreihe und setzt voraus, dass Sie Ausgaben wie in FinOps für Agenten erfassen.
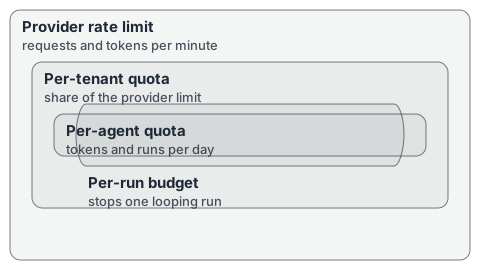
Sättigung ist auch für Agenten ein Golden Signal
Das SRE-Buch von Google nennt, was bei jedem Dienst zu beobachten ist:
The four golden signals of monitoring are latency, traffic, errors, and saturation.
Quelle: Site Reliability Engineering, Chapter 6: Monitoring Distributed Systems (das Buch erschien 2016; die Webseite ist undatiert). Sinngemäß: Die vier Golden Signals sind Latenz, Traffic, Fehler und Sättigung.
Für eine Agentenplattform übersetzt sich das so:
| Signal | Bedeutung bei Agenten |
|---|---|
| Latenz | Zeit je Modellaufruf und je Lauf, getrennt nach Wartezeit und Generierung |
| Traffic | Läufe, Modellaufrufe und Tokens pro Minute |
| Fehler | 429- und 5xx-Antworten des Anbieters, Tool-Fehler, Policy-Ablehnungen |
| Sättigung | Wie nah Sie am Anbieter-Limit, an der GPU-Kapazität oder an einer Quote sind |
Sättigung vergisst man leicht, weil sie bei einem gehosteten Modell wie ein fremdes Problem aussieht. Das ist sie nicht: Ein 429 des Anbieters bedeutet, dass Ihre Agenten ausfallen.
Der Fehler, den die Ebenen verhindern
OWASP führt diese Problemklasse als LLM10:
Unbounded Consumption occurs when a Large Language Model (LLM) application allows users to conduct excessive and uncontrolled inferences
Quelle: LLM10:2025 Unbounded Consumption, OWASP Gen AI Security Project. Sinngemäß: Unbegrenzter Verbrauch entsteht, wenn eine LLM-Anwendung übermäßige und unkontrollierte Inferenz zulässt.
Bei Agenten ist der “Nutzer” oft selbst Software, und eine Schleife braucht keinen Angreifer: Ein Tool, das einen Fehler liefert, den das Modell immer wieder neu versucht, genügt. Das Ergebnis ist dasselbe: übermäßige, unkontrollierte Inferenz, eine ungeplante Rechnung und Nachbarn ohne Kapazität.
Vier Ebenen von Limits
1. Budget je Lauf. Tokens, Modellaufrufe, Tool-Aufrufe und Laufzeit eines Laufs begrenzen. Erreicht ein Lauf die Grenze, wird er mit klarem Status gestoppt, das Teilprotokoll bleibt erhalten. Das ist die günstigste Kontrolle und fängt die meisten Schleifen.
2. Quote je Agent. Eine Tages- oder Stundengrenze für einen Agenten über alle seine Läufe. Eine neue Agentenversion mit Schleife stößt hier an, bevor sie jemand anderem schadet.
3. Quote je Mandant. Eine Grenze je Team, Produkt oder Kunde, meist ein Anteil dessen, was Sie beim Anbieter haben. Diese Ebene verhindert, dass ein Team ein anderes aushungert.
4. Rate Limit des Anbieters. Anfragen und Tokens pro Minute, festgelegt von Anbieter und Tarif. Behandeln Sie es als gemeinsamen Pool und verteilen Sie ihn über die Ebenen 3 bis 1 nach unten. Die Summe der Mandantenquoten sollte höchstens dem Pool entsprechen, sonst müssen Sie einreihen und priorisieren.
Eine Skizze, wie das in einer Konfiguration aussehen könnte. Die Schlüssel sind beispielhaft, kein Schema eines bestimmten Produkts:
provider:
  anthropic:
    tokens_per_minute: 400000
    requests_per_minute: 1000
tenants:
  support:
    share: 0.5            # of the provider pool
    daily_budget_usd: 120
agents:
  triage:
    tenant: support
    daily_tokens: 8000000
    run:
      max_tokens: 200000
      max_model_calls: 40
      max_tool_calls: 25
      max_seconds: 300
Auch lokale GPU-Kapazität ist ein Limit
Wer Modelle selbst betreibt, stößt an Speicher und Durchsatz statt an eine Quote. Das vLLM-Paper geht von diesem Punkt aus:
High throughput serving of large language models (LLMs) requires batching sufficiently many requests at a time.
Quelle: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv, 12.09.2023. Sinngemäß: Hoher Durchsatz beim Betrieb von LLMs setzt voraus, genügend viele Anfragen gleichzeitig zu bündeln.
Die betriebliche Lesart: Ein Serving-Stack wird mit genügend gleichzeitigen Anfragen effizienter, aber jede Anfrage belegt Speicher, sodass es eine Obergrenze gibt, ab der die Latenz stark steigt. Messen Sie sie mit Ihren eigenen Prompts, setzen Sie das Gleichzeitigkeitslimit darunter und stellen Sie eine Warteschlange davor. Rate Limits schützen dann Ihre eigene Hardware statt die eines Anbieters.
Verhalten unter Last
Limits brauchen definiertes Verhalten, sonst verschieben sie den Fehler nur:
- Wiederholen mit Backoff und Jitter bei 429 und den Wiederholungshinweis des Anbieters beachten. Die Zahl der Wiederholungen begrenzen; unbegrenzte Wiederholungen sind wieder die Schleife.
- Nach Priorität einreihen. Interaktive Läufe vor Stapelarbeit; ein Mandant über der Quote wartet, statt andere scheitern zu lassen.
- Gezielt abstufen. Ein Ausweichmodell für unkritische Arbeit benennen und vorab festlegen, welche Agenten nicht ausweichen dürfen.
- Schnell und sichtbar scheitern. Ein durch das Budget gestoppter Lauf sagt das in seinem Status, und die Verantwortlichen werden informiert.
- Stoppen statt ewig drosseln. Ein Lauf, der 80 Prozent seines Budgets ohne Fortschritt verbraucht hat, ist ein Kandidat für vorzeitiges Beenden.
Worauf Alarme gehören
- 429-Rate des Anbieters über einer kleinen Schwelle für fünf Minuten.
- Jeder Mandant über 80 Prozent seiner Quote vor Periodenende.
- Ein Lauf, der sein Budget erreicht hat, gruppiert nach Agentenversion, damit ein fehlerhaftes Release auffällt.
- Wartezeit in der Warteschlange über dem Latenzziel; siehe SLOs für Agenten.
- Ausgaben je Stunde im Vergleich zur gleichen Stunde der Vorwoche.
Caching und Prompt-Gestaltung senken die Last, bevor Limits greifen; siehe Prompt Caching und Token-Budgets.
Eine Beispielansicht
In der aktuellen Demo zeigt eine Budget-Ansicht die Ausgaben gegenüber dem Budget je Agent für erfundene Beispiel-Mandanten, darunter einen Lauf, der durch sein Limit gestoppt wurde. Der Sinn einer solchen Ansicht: Ein Stopp ist ein erwartetes, protokolliertes Ergebnis und kein Rätsel.
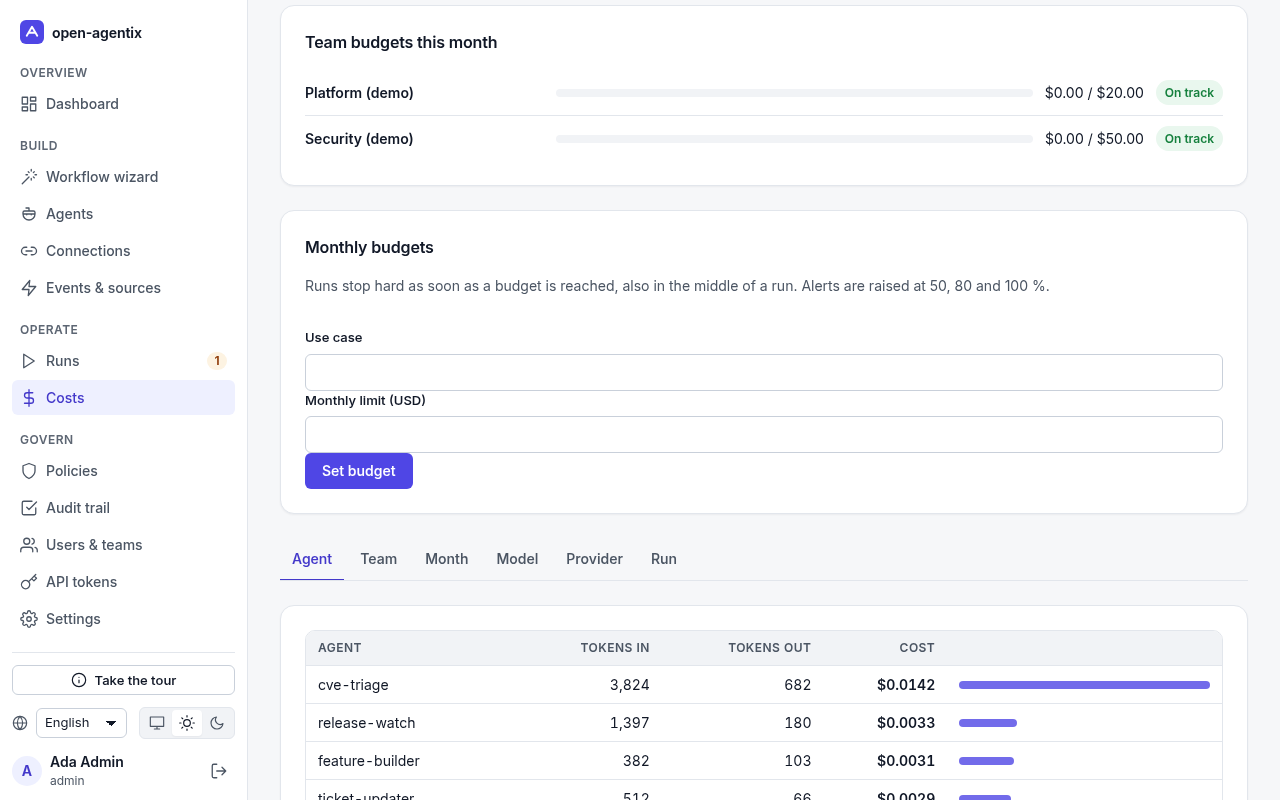
Screenshot der aktuellen Demo (erfundene Daten).
Das Wichtigste in Kürze
- Vier verschachtelte Limits nutzen: Lauf, Agent, Mandant und Anbieter.
- Sättigung ist ein Golden Signal; ein 429 des Anbieters heißt, Ihre Agenten fallen aus.
- Schleifen brauchen keinen Angreifer, nur einen wiederholbaren Fehler: Wiederholungen und Laufdauer begrenzen.
- Verhalten unter Last festlegen: Backoff, Prioritätswarteschlangen, bewusstes Ausweichen, sichtbare Stopps.
- Lokales GPU-Serving hat eine Gleichzeitigkeitsgrenze; messen und eine Warteschlange vorschalten.
Quellen
- OWASP Gen AI Security Project, LLM10:2025 Unbounded Consumption.
- Google, Site Reliability Engineering, Chapter 6: Monitoring Distributed Systems.
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv.