Code-Ausführung oder direkte Tool-Aufrufe? Abwägungen für Entwickler
Code execution agents sparen Token durch Filtern in einer Sandbox, brauchen aber Isolation. Vergleich mit direkten Tool-Aufrufen bei Kosten, Sicherheit, Audit.
Dieser Beitrag ist auch auf English verfügbar.
Direkte Tool-Aufrufe sind einfacher, leichter zu prüfen und für die meisten Agenten völlig ausreichend. Code-Ausführung, bei der das Modell ein Skript gegen Tool-APIs schreibt und eine Sandbox es ausführt, kann den Tokenverbrauch drastisch senken, wenn Aufgaben viele Werkzeuge oder große Zwischenergebnisse berühren. Sie braucht aber echte Isolation und verlagert die Durchsetzung von Richtlinien an eine neue Stelle. Die Wahl hängt von der Last ab: wenige Werkzeuge und kleine Ergebnisse sprechen für direkte Aufrufe, viele Werkzeuge, große Datenmengen und mehrstufige Schleifen für Code. Dieser Beitrag vergleicht beide Ansätze bei Kosten, Sicherheit und Nachvollziehbarkeit.
Die zwei Modelle
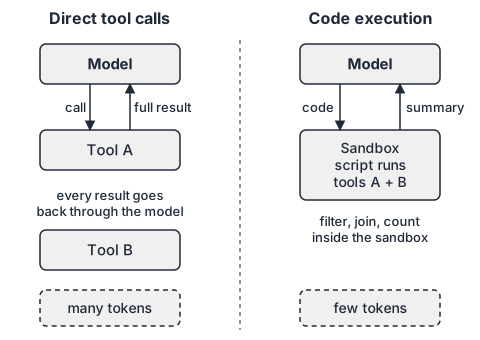
Direkte Tool-Aufrufe. Das Modell erzeugt einen strukturierten Aufruf, der Harness führt ihn aus, und das vollständige Ergebnis landet wieder im Kontext des Modells. Danach entscheidet das Modell über den nächsten Aufruf. Jedes Zwischenergebnis läuft durch das Modell.
Code-Ausführung. Die Werkzeuge stehen als Funktionen in einer Programmiersprache bereit. Das Modell schreibt ein kurzes Programm, das sie aufruft, die Ergebnisse im Code filtert oder aggregiert und nur zurückgibt, was gebraucht wird. Nur die Ausgabe des Programms gelangt in den Kontext.
Die Idee hat akademische Wurzeln. Das CodeAct-Paper schlägt Code als Aktionsformat vor:
This work proposes to use executable Python code to consolidate LLM agents’ actions into a unified action space (CodeAct).
Quelle: Executable Code Actions Elicit Better LLM Agents, arXiv. Sinngemäß: Die Arbeit schlägt vor, ausführbaren Python-Code zu verwenden, um die Aktionen von LLM-Agenten in einem einheitlichen Aktionsraum zu bündeln. Der Reiz: Code liefert Schleifen, Bedingungen und Variablen gratis, ein Schritt kann also leisten, wofür sonst viele einzelne Tool-Aufrufe nötig wären.
Woher die Tokenkosten kommen
Bei direkten Tool-Aufrufen treiben zwei Effekte die Kosten. Erstens die Tool-Definitionen: Name, Beschreibung und Schema jedes Werkzeugs stehen im Kontext. Zweitens die Zwischenergebnisse: Ein Dokument, das aus einem System geholt und in ein anderes geschrieben wird, läuft zweimal durch das Modell.
Das Engineering-Team von Anthropic beschreibt den ersten Effekt im großen Maßstab:
In cases where agents are connected to thousands of tools, they’ll need to process hundreds of thousands of tokens before reading a request.
Und es nennt den Effekt des Wechsels zu Code-Ausführung in einem durchgerechneten Beispiel:
This reduces the token usage from 150,000 tokens to 2,000 tokens—a time and cost saving of 98.7%.
Quelle für beide: Code execution with MCP: building more efficient AI agents, Anthropic. Sinngemäß: Bei tausenden angebundenen Werkzeugen müssen Agenten hunderttausende Token verarbeiten, bevor sie eine Anfrage lesen; im Beispiel sinkt der Verbrauch von 150.000 auf 2.000 Token. Die 98,7 Prozent sind das Ergebnis eines Beispiels, kein Versprechen. Ihre Einsparung hängt davon ab, wie viele Daten Ihre Aufgaben bewegen und wie viel davon das Modell wirklich sehen muss. Besteht jedes Tool-Ergebnis nur aus einer kurzen Statuszeile, gibt es wenig zu sparen; dann sind Caching und Token-Budgets der bessere Hebel (siehe Prompt-Caching und Token-Budgets).
Sicherheit: was sich mit Code-Ausführung ändert
Bei direkten Aufrufen sieht der Harness jeden Aufruf, bevor er ihn ausführt. Das ist ein natürlicher Ort für die Richtlinienprüfung: Ist das Werkzeug erlaubt, liegen die Argumente im Rahmen, muss ein Mensch freigeben? Der Aufruf ist ein Datum, und Daten lassen sich validieren.
Bei Code-Ausführung übergibt das Modell ein Programm. Das Programm kann Schleifen bilden, Argumente dynamisch bauen und viele Werkzeuge in einem Zug aufrufen. Richtlinien lassen sich weiterhin durchsetzen, aber an zwei Stellen:
- An der Grenze der Sandbox. Jede in der Sandbox bereitgestellte Tool-Funktion ist ein dünner Client, der das echte Werkzeug über ein Gate aufruft. Das Gate wendet dieselbe Freigabeliste, Argumentprüfung, Ratenbegrenzung und Genehmigungsregeln an wie bei direkten Aufrufen.
- Um die Sandbox selbst. Der Code läuft auf Ihrer Infrastruktur und muss von allem isoliert sein, was er nicht braucht.
Der Anthropic-Artikel zum Sandboxing in Claude Code sagt den zweiten Punkt deutlich:
It is worth noting that effective sandboxing requires both filesystem and network isolation.
Quelle: Making Claude Code more secure and autonomous with sandboxing, Anthropic. Sinngemäß: Wirksames Sandboxing erfordert sowohl Dateisystem- als auch Netzwerkisolation. Ohne Netzwerkisolation kann ein kompromittiertes Skript Daten abfließen lassen, ohne Dateisystemisolation kommt es an Zugangsdaten oder verändert Dateien, die es nicht anfassen sollte. Derselbe Artikel nennt einen praktischen Nutzen einer funktionierenden Sandbox:
In our internal usage, we’ve found that sandboxing safely reduces permission prompts by 84%.
Isolation ist also nicht nur ein Kostenpunkt. Sie kann mehr Autonomie erlauben, weil die sichere Voreinstellung von der Umgebung durchgesetzt wird, statt jedes Mal einen Menschen zu fragen. Konkrete Isolationsoptionen und Prüfpunkte stehen in Agenten in der Sandbox betreiben.
Nachvollziehbarkeit
Direkte Aufrufe erzeugen ein sauberes Protokoll: ein Eintrag pro Aufruf, mit Argumenten und Ergebnis. Code-Ausführung erzeugt weniger, größere Ereignisse: den Programmtext, die darüber abgesetzten Tool-Aufrufe und die Ausgabe. Damit es prüfbar bleibt:
- Den Programmtext und seinen Hash mit dem Lauf protokollieren.
- Jeden Tool-Aufruf durch das Gate aus der Sandbox heraus protokollieren, mit denselben Feldern wie bei direkten Aufrufen.
- Ressourcenlimits festhalten und ob das Programm sie erreicht hat (Zeit, Speicher, Ausgabegröße).
- Die Version des Sandbox-Images im Laufprotokoll ablegen, damit sich ein Lauf reproduzieren lässt.
Wenn Sie aus dem Protokoll nicht beantworten können, welche Tool-Aufrufe dieses Skript mit welchen Argumenten abgesetzt hat, ist das Setup nicht reif für sensible Aufgaben.
Entscheidungshilfe
| Situation | Besser geeignet |
|---|---|
| Wenige Werkzeuge, kleine Ergebnisse | Direkte Tool-Aufrufe |
| Strikte Freigabe jedes Aufrufs durch einen Menschen | Direkte Tool-Aufrufe |
| Hunderte Werkzeuge, die meisten für die Aufgabe irrelevant | Code-Ausführung (Tool-Definitionen bei Bedarf laden) |
| Große Zwischendaten (Tabellen, Dokumente), die das Modell nur zusammenfassen muss | Code-Ausführung |
| Schleifen, Joins oder Filter über viele Datensätze | Code-Ausführung |
| Keine Möglichkeit, eine isolierte Sandbox zu betreiben | Direkte Tool-Aufrufe |
| Compliance verlangt einen Prüfeintrag pro Aufruf | Beides, mit protokollierten Gate-Aufrufen in beiden Fällen |
Häufig ist ein Mischbetrieb sinnvoll: wenige gut gestaltete direkte Werkzeuge für sensible Aktionen (Ticket anlegen, Nachricht senden) und Code-Ausführung für das datenlastige Aufbereiten. Gutes Tool-Design zählt in beiden Modi; siehe Werkzeuge schreiben, die Agenten nutzen können.
Ein minimales Gate für Tool-Funktionen in der Sandbox
Die Skizze zeigt die Idee: In der Sandbox spricht eine Tool-Funktion nicht direkt mit dem System, sondern schickt eine Anfrage an ein Gate, das die Richtlinie durchsetzt.
# läuft in der Sandbox; tools.call() geht an das Gate, nicht ins Netz
from tools import call

rows = call("tickets.search", {"status": "open", "limit": 500})
urgent = [r for r in rows if r["priority"] == "high"]
print({"count": len(rows), "urgent_ids": [r["id"] for r in urgent][:20]})
Nur die ausgegebene Zusammenfassung gelangt zurück in den Kontext des Modells. Das Gate kann tickets.search-Aufrufe mit unzulässigen Limits ablehnen, Aufrufe pro Lauf zählen und für schreibende Werkzeuge eine Freigabe verlangen, genau wie bei einem direkten Aufruf.
Grenzen und offene Punkte
- Erzeugter Code kann auf schwerer erkennbare Weise falsch sein als ein fehlerhafter Tool-Aufruf. Testen Sie das Verhalten der Skripte, nicht nur ihre Syntax.
- Eine Sandbox verringert das Risiko, beseitigt es aber nicht. Halten Sie Geheimnisse fern und geben Sie nur die Tool-Funktionen hinein, die die Aufgabe braucht.
- Die Latenz kann in beide Richtungen gehen: weniger Modell-Runden, aber Startzeit der Sandbox.
- Ergebnisse aus einem Beispiel, etwa die oben genannte Token-Reduktion, übertragen sich nicht automatisch auf Ihre Last. Messen Sie an Ihren eigenen Aufgaben.
Das Wichtigste in Kürze
- Direkte Tool-Aufrufe sind der einfache Standard; Richtlinienprüfung und Audit sind unkompliziert.
- Code-Ausführung lohnt sich, wenn viele Werkzeuge oder große Zwischenergebnisse den Kontext aufblähen.
- Richtlinien an der Sandbox-Grenze mit einem Gate durchsetzen und sowohl Dateisystem als auch Netzwerk isolieren.
- Programmtext, Gate-Aufrufe und Ressourcenlimits protokollieren, damit Läufe prüfbar bleiben.
- Ein Mischbetrieb aus direkten Werkzeugen für sensible Schreibzugriffe und Code für die Datenaufbereitung ist oft die praktische Antwort.