Bereitschaft der Agentenplattform: die Prüfliste, die die Reihe zusammenführt
Checkliste zur Produktionsreife von KI-Agenten über Architektur, Skills, Sicherheit, Betrieb, Kosten und Evaluation, jeder Punkt mit Link zum Beitrag.
Dieser Beitrag ist auch auf English verfügbar.
Produktionsreife ist nicht eine Frage, sondern sechs. Ist die Architektur geprüft, sind Skills geregelt, ist die Sicherheit kontrolliert, lässt sich das System betreiben, sind die Kosten im Griff und lässt sich feststellen, ob es funktioniert? Diese Prüfliste zur Produktionsreife von KI-Agenten legt einen Satz von Punkten über alle sechs Bereiche, jeder verlinkt auf den Beitrag dieser Reihe, der ihn erklärt. Nutzen Sie sie als letztes Tor vor dem ersten Produktionslauf und danach als regelmäßige Prüfung. Sie ersetzt kein formales Risikoverfahren; sie stellt sicher, dass die grundlegenden Fragen gestellt wurden.
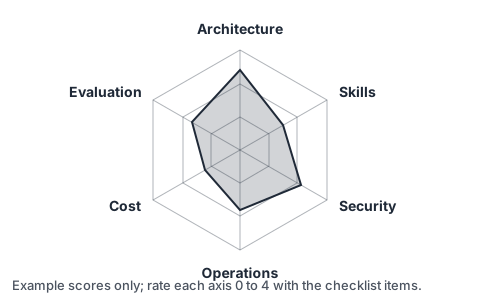
Bewerten Sie jeden Bereich von 0 (nichts vorhanden) bis 4 (vorhanden, getestet und zugeordnet), tragen Sie die sechs Werte im Radar ein und betrachten Sie die schwächste Achse, nicht den Durchschnitt. Eine Plattform, die bei der Evaluation hervorragend ist und keine Incident Response hat, ist nicht bereit.
Einordnung in größere Rahmenwerke
Für Organisationen, die ein Rahmenwerk brauchen, gibt es welche. Das NIST AI Risk Management Framework beschreibt sich als freiwillig:
The NIST AI Risk Management Framework (AI RMF) is intended for voluntary use and to improve the ability to incorporate trustworthiness considerations
Quelle: AI Risk Management Framework, NIST (AI RMF 1.0 veröffentlicht am 26.01.2023). Sinngemäß: Das Rahmenwerk ist für freiwillige Nutzung gedacht und soll helfen, Aspekte der Vertrauenswürdigkeit einzubeziehen.
Für die Sicherheitsseite ist die OWASP-Liste für agentische Anwendungen der naheliegende Begleiter:
identifies the most critical security risks facing autonomous and agentic AI systems.
Quelle: OWASP Top 10 for Agentic Applications for 2026, OWASP Gen AI Security Project, 09.12.2025. Sinngemäß: Sie benennt die kritischsten Sicherheitsrisiken autonomer und agentischer KI-Systeme.
Die folgende Liste ist praktisch und enger gefasst: Sie fragt, ob ein Plattformteam Agenten im Alltag sicher betreiben kann.
1. Architektur
- Das System hat ein einseitiges Review zu Zweck, Grenzen, Datenfluss, Verträgen, Autonomie und Fehlerpfaden. Siehe Ein Architektur-Review für Agentensysteme auf einer Seite.
- Ein fester Workflow wurde erwogen, bevor ein Agent gewählt wurde.
- Übergaben zwischen Agenten und Tools sind Schemas, keine Prosa.
- Entscheidungen sind mit Begründung festgehalten, und das Review hat ein Datum zur Wiederholung.
2. Skills
- Skills stammen aus einem Katalog mit Verantwortlichen, Versionen und Prüfdaten. Siehe Einen internen Skill-Katalog aufbauen.
- Jeder Skill wurde auf Sicherheit geprüft und hat mindestens eine Eval.
- Verbraucher legen Versionen fest; Upgrades werden wie Abhängigkeiten geprüft.
- Verwaiste oder veraltete Skills werden planmäßig ausgemustert.
3. Sicherheit
- Die zwanzig Fragen der Sicherheits-Prüfliste für Agenten sind je Agent mit Nachweis beantwortet.
- Kein einzelner Agent verbindet private Daten, nicht vertrauenswürdige Eingaben und einen ausgehenden Kanal.
- Ein deterministisches Gate steht zwischen Modellausgabe und Seiteneffekten; siehe Policy entscheidet, Audit beweist.
- Jeder Agent hält nur die Tools, die sein Schritt braucht; siehe minimale Rechte für Agenten.
4. Betrieb
- Der Zeilenvergleich aus Agentenplattformen unterscheiden sich kaum vom klassischen Betrieb wurde durchgegangen, und Lücken haben Verantwortliche.
- Not-Aus, Entzug von Zugangsdaten und Wiedergabe eines Laufs wurden getestet, nicht nur dokumentiert.
- Observability deckt Modellaufrufe, Tool-Aufrufe, Fehler und Sättigung ab.
- Änderungen an Prompts, Skills und Modellen durchlaufen Prüfung und gestaffelten Rollout.
5. Kosten
- Budgets gibt es je Lauf, je Agent und je Mandant, und ein Lauf, der ein Budget erreicht, stoppt mit sichtbarem Status.
- Ausgaben werden je Anwendungsfall zugeordnet, und jemand prüft sie regelmäßig.
- Rate Limits des Anbieters und lokale Kapazität sind bekannt und überwacht.
- Die Kosten je akzeptierter Änderung lassen sich berechnen.
6. Evaluation
- Es gibt einen Eval-Satz für die Hauptaufgaben des Agenten, der bei jeder Änderung an Prompts, Skills oder Modell läuft. Ein Grader ist nüchtern definiert:
A grader is logic that scores some aspect of the agent’s performance.
Quelle: Demystifying evals for AI agents, Anthropic, 09.01.2026. Sinngemäß: Ein Grader ist Logik, die einen Aspekt der Leistung des Agenten bewertet.
- Ergebnisse werden in der Umgebung geprüft, nicht nur im Gesprächsverlauf. Derselbe Artikel nennt ein Beispiel dafür:
the outcome is whether a reservation exists in the environment’s SQL database.
Sinngemäß: Das Ergebnis ist, ob in der SQL-Datenbank der Umgebung eine Reservierung existiert.
- Ziele sind als SLOs mit gemessenem Indikator formuliert. Das SRE-Buch liefert die Definition:
An SLO is a service level objective: a target value or range of values for a service level that is measured by an SLI.
Quelle: Site Reliability Engineering, Chapter 4: Service Level Objectives (das Buch erschien 2016; die Webseite ist undatiert). Sinngemäß: Ein SLO ist ein Zielwert oder Wertebereich für ein Service-Level, das durch einen SLI gemessen wird.
- Ein Ausgangswert zum Vergleichen existiert, sodass sich eine Verbesserung belegen lässt.
Durchgespieltes Beispiel: die Prüfung vor dem ersten Lauf
Die aktuelle Demo hat eine Agent-Check- oder Plan-Ansicht: Für einen Beispielprozess listet sie die Tools, Policies und das Budget auf, die der Agent vor seinem ersten Lauf nutzen würde. Das ist der Bereitschaftsgedanke im Kleinen: Bevor etwas läuft, kann eine lesende Person sehen, was der Agent berühren darf und welche Grenzen gelten, und dann entscheiden.
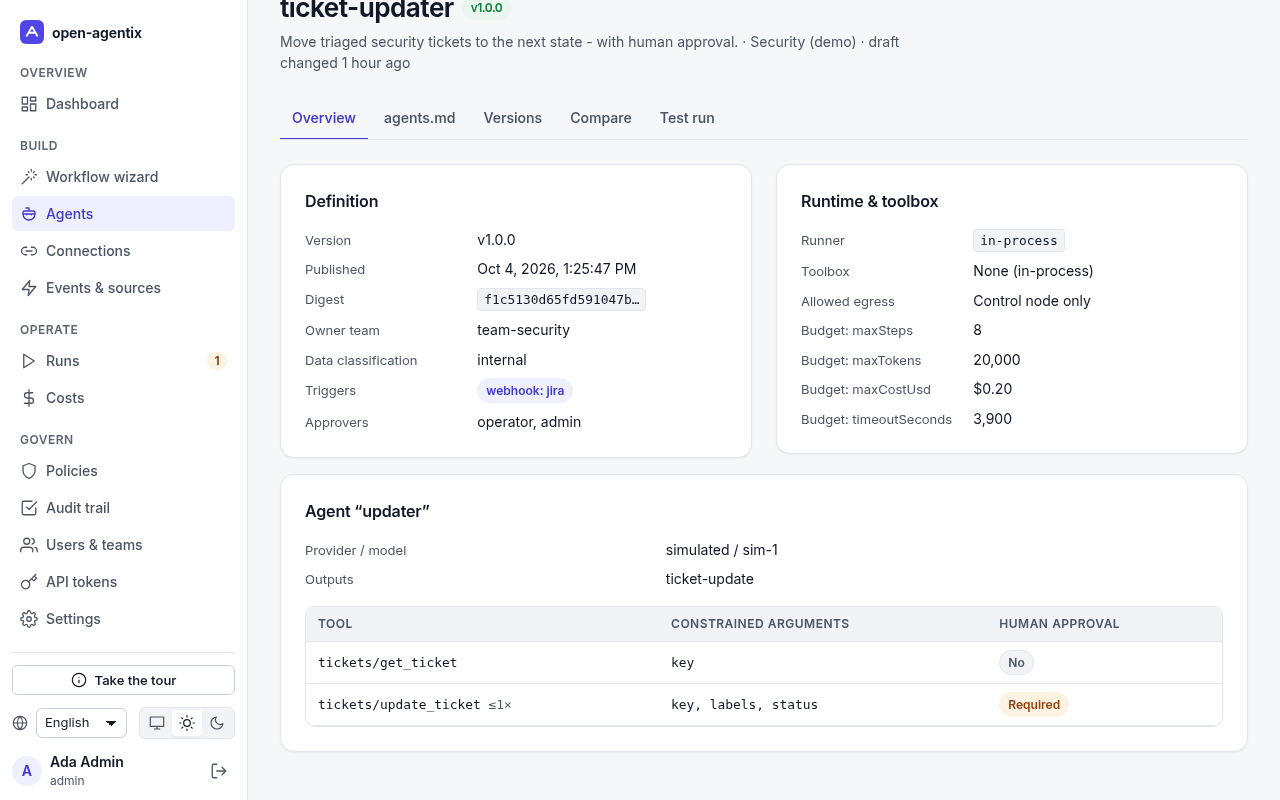
Screenshot der aktuellen Demo (erfundene Daten).
Die Liste anwenden
- Ehrlich bewerten. Wenn Sie für einen Punkt keinen Nachweis zeigen können, ist er eine 0.
- Eine Schwelle festlegen. Für einen Produktionsstart mindestens 3 von 4 bei Sicherheit, Betrieb und Evaluation verlangen und einen Plan für den Rest.
- Verantwortliche und Termine für jedes offene Kästchen vergeben.
- Wiederholen nach jeder Änderung von Modell, Tool-Satz oder Autonomiestufe und mindestens vierteljährlich.
- Das Ergebnis aufbewahren, zusammen mit den Architekturentscheidungen, damit die nächste prüfende Person sieht, was akzeptiert wurde und warum.
Das Wichtigste in Kürze
- Reife umfasst sechs Bereiche: Architektur, Skills, Sicherheit, Betrieb, Kosten und Evaluation.
- Nach der schwächsten Achse urteilen, nicht nach dem Durchschnitt.
- Jeder Punkt braucht einen Nachweis; “wahrscheinlich” ist eine Null.
- Not-Aus, Entzug und Wiedergabe testen; Dokumentation allein ist keine Bereitschaft.
- Die Liste erneut durchgehen, wenn sich Modell, Tools oder Autonomie ändern.
Quellen
- OWASP Gen AI Security Project, OWASP Top 10 for Agentic Applications for 2026, 09.12.2025.
- NIST, AI Risk Management Framework.
- Anthropic, Demystifying evals for AI agents, 09.01.2026.
- Google, Site Reliability Engineering, Chapter 4: Service Level Objectives.