Rückblick Betriebsreihe: Agentenplattformen unterscheiden sich kaum vom klassischen Betrieb
Betrieb von KI-Plattformen im Rückblick: Tabelle von zwölf Disziplinen, was aus DevOps und SRE übernommen wird und was bei Agenten wirklich neu ist.
Dieser Beitrag ist auch auf English verfügbar.
Der Betrieb von KI-Plattformen wirkt von außen neu und von innen vertraut. Das meiste, was eine Agentenplattform gesund hält, hält auch jeden anderen Produktionsdienst gesund: Identität, minimale Rechte, kontrollierte Änderungen, Observability, Incident Response, Ziele, Kostenkontrolle, Audit, Runbooks, Patching und Secrets. Manches ist wirklich anders, vor allem weil das Verhalten des Systems von Text und von einem Modell abhängt, das Sie nicht kontrollieren. Dieser Rückblick schließt die Betriebsreihe mit einer Gegenüberstellung ab und sagt je Zeile, was übernommen werden kann und was neu ist.
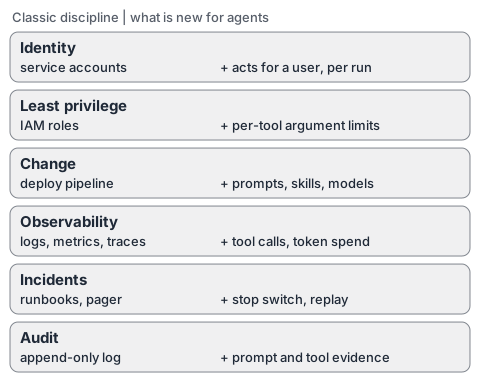
Kurz gesagt: Wer Dienste gut betreibt, ist schon weit; wer es nicht tut, dem zeigen Agenten das schneller. Die Reihe begann mit dem Argument in Agent-Betrieb ist einfach Betrieb; dies ist der Abgleich mit dem, was folgte.
Gegenüberstellung
| Disziplin | Klassischer Betrieb | Neu bei Agenten |
|---|---|---|
| Identität | Servicekonten, Workload-Identität | Ein Agent handelt für einen Nutzer und für sich selbst; beides wird je Aufruf festgehalten |
| Minimale Rechte | Rollen und Scopes je Dienst | Grenzen für Tool-Argumente, nicht nur für das Tool, und Zerlegung je Schritt |
| Änderungsmanagement | Code-Review, CI, gestaffelter Rollout | Prompts, Skills, Tool-Beschreibungen und Modellversionen sind ebenfalls Änderungen |
| Deployment | Unveränderliche Artefakte, Canaries | Verhalten kann sich ohne Deployment ändern, wenn ein Anbieter ein Modell aktualisiert |
| Observability | Logs, Metriken, Traces | Traces von Modell- und Tool-Aufrufen, Token- und Kostenmetriken, inhaltsbezogene Prüfung |
| Vorfälle | Pager, Runbook, Postmortem | Not-Aus, Entzug von Zugangsdaten, Wiedergabe dessen, was der Agent getan hat |
| SLOs | Verfügbarkeit, Latenz, Fehlerrate | Ziele für Aufgabenerfolg und Qualität neben der Latenz |
| Kosten | Kapazitätsplanung, Budgets | Variable, nutzungsabhängige Ausgaben; Budgets je Lauf, Agent und Mandant |
| Audit | Nur anhängbare Logs, Zugriffsnachweise | Nachweis, was das Modell gefragt wurde, was es vorschlug und was die Policy entschied |
| Runbooks | Dokumentierte Abläufe | Abläufe, denen ein Agent folgen darf, als Skills mit Freigaben |
| Patching | Betriebssystem- und Abhängigkeits-Updates | Auch Skills, MCP-Server, Modellversionen und Prompt-Bibliotheken |
| Secrets | Tresor, Rotation | Geheimnisse aus dem Modellkontext heraushalten; Zugangsdaten leben in der Tool-Schicht |
Für mehrere Zeilen gibt es eigene Beiträge: Agenten-Änderungen sicher ausrollen, Audit-Trails und Logs und Kapazität und Rate Limits.
Was unverändert gilt
Toil schmerzt weiterhin. Das SRE-Buch definiert ihn genau:
Toil is the kind of work tied to running a production service that tends to be manual, repetitive, automatable, tactical, devoid of enduring value
Quelle: Site Reliability Engineering, Chapter 5: Eliminating Toil (das Buch erschien 2016; die Webseite ist undatiert). Sinngemäß: Toil ist Arbeit im Betrieb eines Produktionsdienstes, die manuell, repetitiv, automatisierbar, taktisch und ohne bleibenden Wert ist.
Agentenplattformen erzeugen neuen Toil, wenn man es nicht verhindert: dieselbe unkritische Aktion jeden Tag von Hand freigeben, Evals manuell wiederholen, Tokens nach Kalendererinnerung rotieren. Die Abhilfe ist die übliche: automatisieren oder die Notwendigkeit beseitigen. Agenten können Toil abbauen, aber ein Agent, der Toil ohne Grenzen automatisiert, ist ein neues Risiko, das betrieben werden muss.
Incident Response ist eine Disziplin, kein Werkzeug. Die Empfehlungen des NIST zur Reaktion auf Vorfälle betonen, dass sich Vorbereitung auszahlt:
Doing so can help organizations prepare for incident responses, reduce the number and impact of incidents that occur
Quelle: SP 800-61 Rev. 3, Incident Response Recommendations and Considerations for Cybersecurity Risk Management, NIST, 03.04.2025. Sinngemäß: Das hilft Organisationen, sich auf die Reaktion auf Vorfälle vorzubereiten und die Zahl und Auswirkung von Vorfällen zu verringern.
Die agentenspezifische Vorbereitung ist klein und konkret: Wer kann einen Lauf stoppen, wie werden Zugangsdaten binnen Minuten entzogen, wie bleibt das Protokoll eines Laufs erhalten und welche Aktionen hätte ein Agent ausführen können, die rückgängig gemacht werden müssen.
Was wirklich neu ist
- Verhalten entsteht aus Text. Prompts, Skill-Anweisungen und Tool-Beschreibungen steuern Aktionen, sodass eine Formulierungsänderung verändern kann, was das System tut. Versionieren und prüfen Sie sie wie Code.
- Die Eingabe kann das System angreifen. Vom Modell verarbeitete, nicht vertrauenswürdige Inhalte können Anweisungen enthalten. Übliche Eingabevalidierung beseitigt das nicht; nötig sind strukturelle Kontrollen wie Gates zwischen Modellausgabe und Seiteneffekten.
- Ausgaben sind probabilistisch. Dieselbe Eingabe kann unterschiedliche Ergebnisse liefern, sodass ein Ziel wie “Erfolgsquote auf diesem Aufgabensatz” an die Stelle von “die Funktion liefert den richtigen Wert” tritt.
- Ein Anbieter kann die Komponente ändern. Ein gehostetes Modell kann nach dem Zeitplan des Anbieters aktualisiert oder abgekündigt werden. Versionen nach Möglichkeit festlegen und einen Eval-Satz bereithalten, um Drift zu erkennen.
- Kosten skalieren mit dem Verhalten. Eine Schleife oder ein ausführlicher Prompt zeigt sich direkt auf der Rechnung.
Telemetrie-Standards holen auf
Sie müssen kein eigenes Telemetrieformat erfinden. Das OpenTelemetry-Projekt beschreibt die Richtung:
establish standards around the shape of the telemetry generated by agent apps to avoid lock-in
Quelle: AI Agent Observability - Evolving Standards and Best Practices, OpenTelemetry, 06.03.2025. Sinngemäß: Standards für die Form der von Agenten-Apps erzeugten Telemetrie schaffen, um Abhängigkeit von einem Anbieter zu vermeiden.
Erzeugen Sie Traces mit Spans für Modell- und Tool-Aufrufe in einem herstellerneutralen Format, damit Sie das Backend später wechseln können. Die Standards entwickeln sich noch; kapseln Sie die Zuordnung an einer Stelle.
Eine Illustration für eine Zeile
Für die Audit-Zeile zeigt die aktuelle Demo eine Audit-Kette: verkettete Einträge mit Hashes für einen Beispiellauf, mit einem Prüfsiegel. Die Idee lässt sich auf jeden Stack übertragen: Aufzeichnungen, die sich nicht unbemerkt ändern lassen, sodass “was ist passiert” eine überprüfbare Antwort hat.
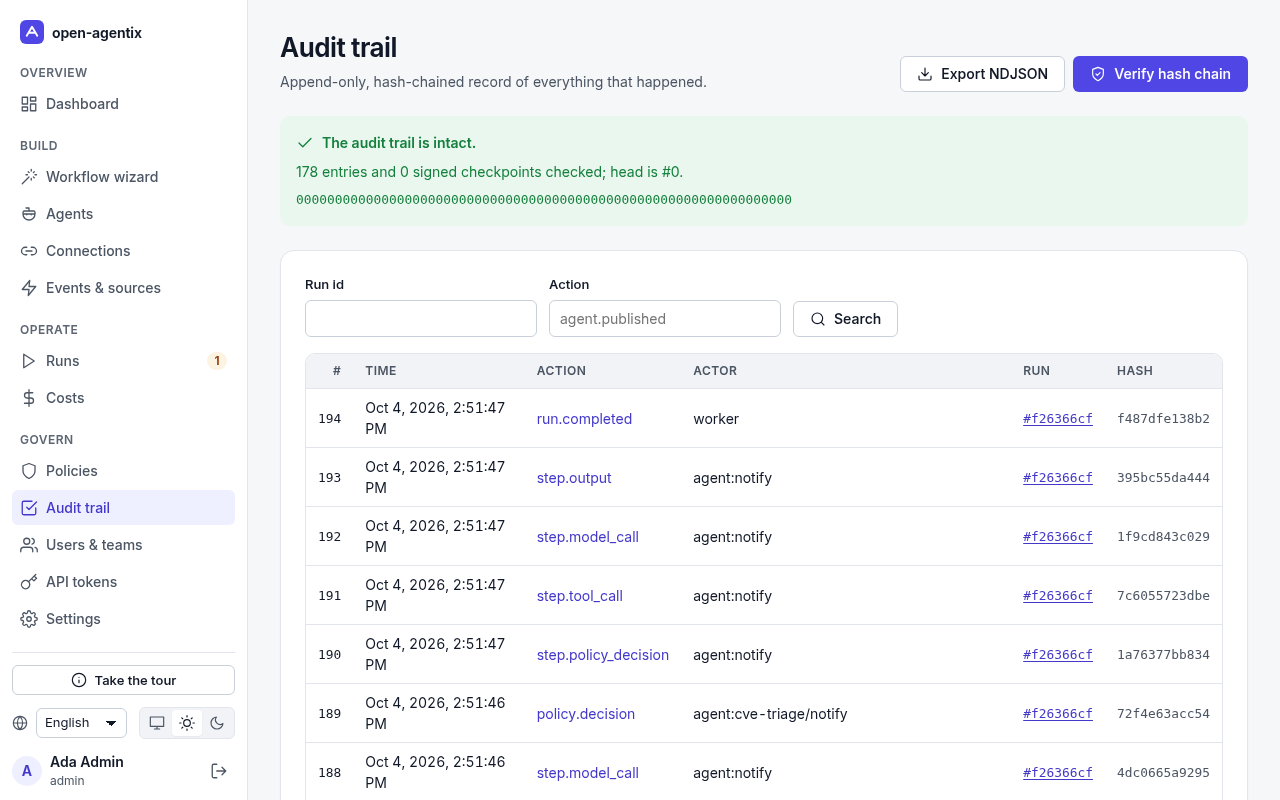
Screenshot der aktuellen Demo (erfundene Daten).
Ein Selbsttest
Wählen Sie eine beliebige Zeile der Tabelle und stellen Sie drei Fragen. Beherrschen wir die klassische Variante? Haben wir den agentenspezifischen Teil ergänzt? Wer ist zuständig? Zeilen, bei denen die erste Antwort “nein” lautet, sind die günstigsten Verbesserungen, weil der Agentenanteil darauf aufbaut.
Das Wichtigste in Kürze
- Agentenplattformen werden mit denselben Disziplinen betrieben wie andere Dienste; die Grundlagen lassen sich übernehmen.
- Neu sind: Verhalten aus Text, feindliche Eingaben, probabilistische Ausgaben, vom Anbieter geänderte Komponenten und nutzungsabhängige Kosten.
- Prompts, Skills, Tool-Beschreibungen und Modelle als Änderungen mit Prüfung und Rollout behandeln.
- Incident Response vor dem ersten Vorfall vorbereiten: stoppen, entziehen, wiedergeben.
- Herstellerneutrale Telemetrie nutzen und Toil im Griff behalten.
Quellen
- Google, Site Reliability Engineering, Chapter 5: Eliminating Toil.
- NIST, SP 800-61 Rev. 3, 03.04.2025.
- OpenTelemetry, AI Agent Observability - Evolving Standards and Best Practices, 06.03.2025.